
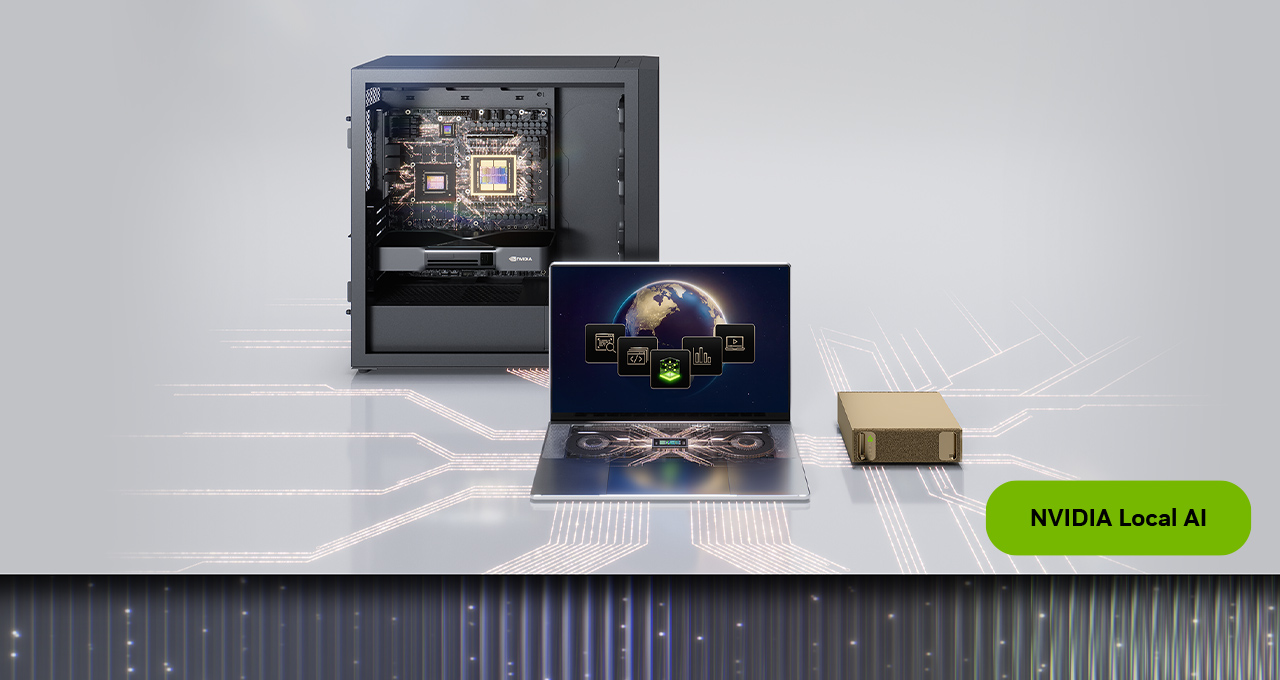
GTC Berlin で NVIDIA は、ローカル AI ハードウェアのフルラインアップを紹介しています。先週発売された RTX Spark は Windows PC 上のパーソナル エージェントを支え、DGX Spark は Linux 上でアプリケーションの構築と拡張を行う開発者を支援します。DGX Station は Linux 上でフロンティア ワークロードを実行する企業のチームに対応し、Windows 版も 12 月に登場します。
主な発表は以下のとおりです。
- RTX Spark 向けに Underdog Desktop Agent の提供を開始
- DGX Spark 64GB を 10 月 23 日 (金) に発売
- NVIDIA Sync が 8 台の DGX Spark に対応し、今月中に Model Launcher を追加
- DGX Spark の 10 月のソフトウェア アップデートで Wi-Fi Assistant を追加し、DGX Spark Skills を更新
- DGX Station が 7 つの新しい統合により管理性を向上
- DGX Station for Windows が 12 月に登場し、多数の製造業向けアプリやエージェント ハーネスをサポート
- DGX Station 上のロボティクス向けに、3 つの新しいオープンソースのリファレンス ワークフローを公開
- DGX Station 向けに NVIDIA Cloud Functions を早期アクセスで提供予定
- NVIDIA のローカル ハードウェア向けに、新しいローカル コーディング モデル Recursive Flint の提供を開始
- Nemotron、GLM、DeepSeek、Qwen、MiniMax、3 の新しい AI モデルに公開初日から対応
- cpp および vLLM 推論エンジンの新たな高速化と、ローカル AI ハードウェア向けに最適化された新しいチェックポイント コレクションを提供
以下でローカル AI に関する発表の詳細をご覧いただき、GTC Berlin のデモやセッションもご確認ください。
RTX Spark が Windows PC にパーソナル エージェントをもたらす
RTX Spark は PC の新たな幕開けを告げます。最大 128 GB の統合メモリと 1 ペタフロップスの AI 演算能力により、パーソナル エージェントの実行、コンテンツ制作の高速化、1440p 解像度で毎秒 100 フレームのゲーミングを実現します。
10 月 16 日の発売以来、レビュアーからは、このプラットフォームについて次のような評価が寄せられています。
「本格的なクリエイターにとって夢のようなマシン……」— CGMag
「AI の未来を見据えた設計……」— The Verge
「極めて高性能で、驚くほど持ち運びやすく、効率的なマシン……」— PCMag
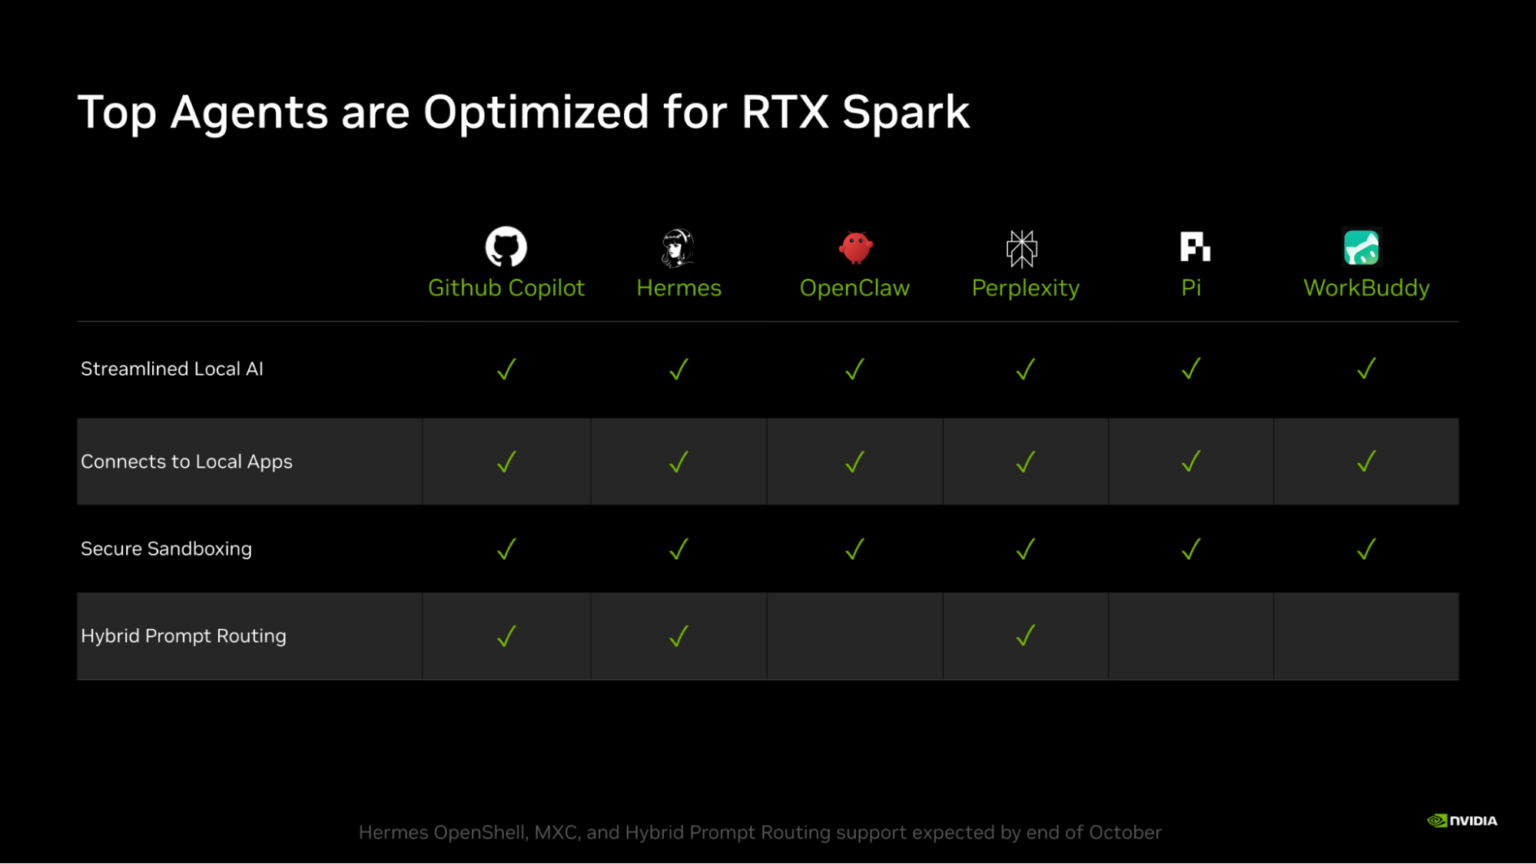
完全にローカルで動作するプライベートな AI 向けに構築された新しいデスクトップ エージェント アプリ、Underdog も、RTX Spark にその体験を提供します。モデル専用の推論エンジン Husky を搭載した Underdog は、モデルをデバイス内で完全に実行するため、ユーザーのデータを PC の外部に一切送信することなく、パーソナル エージェントが作業を進められます。Underdog は現在ダウンロードできます。
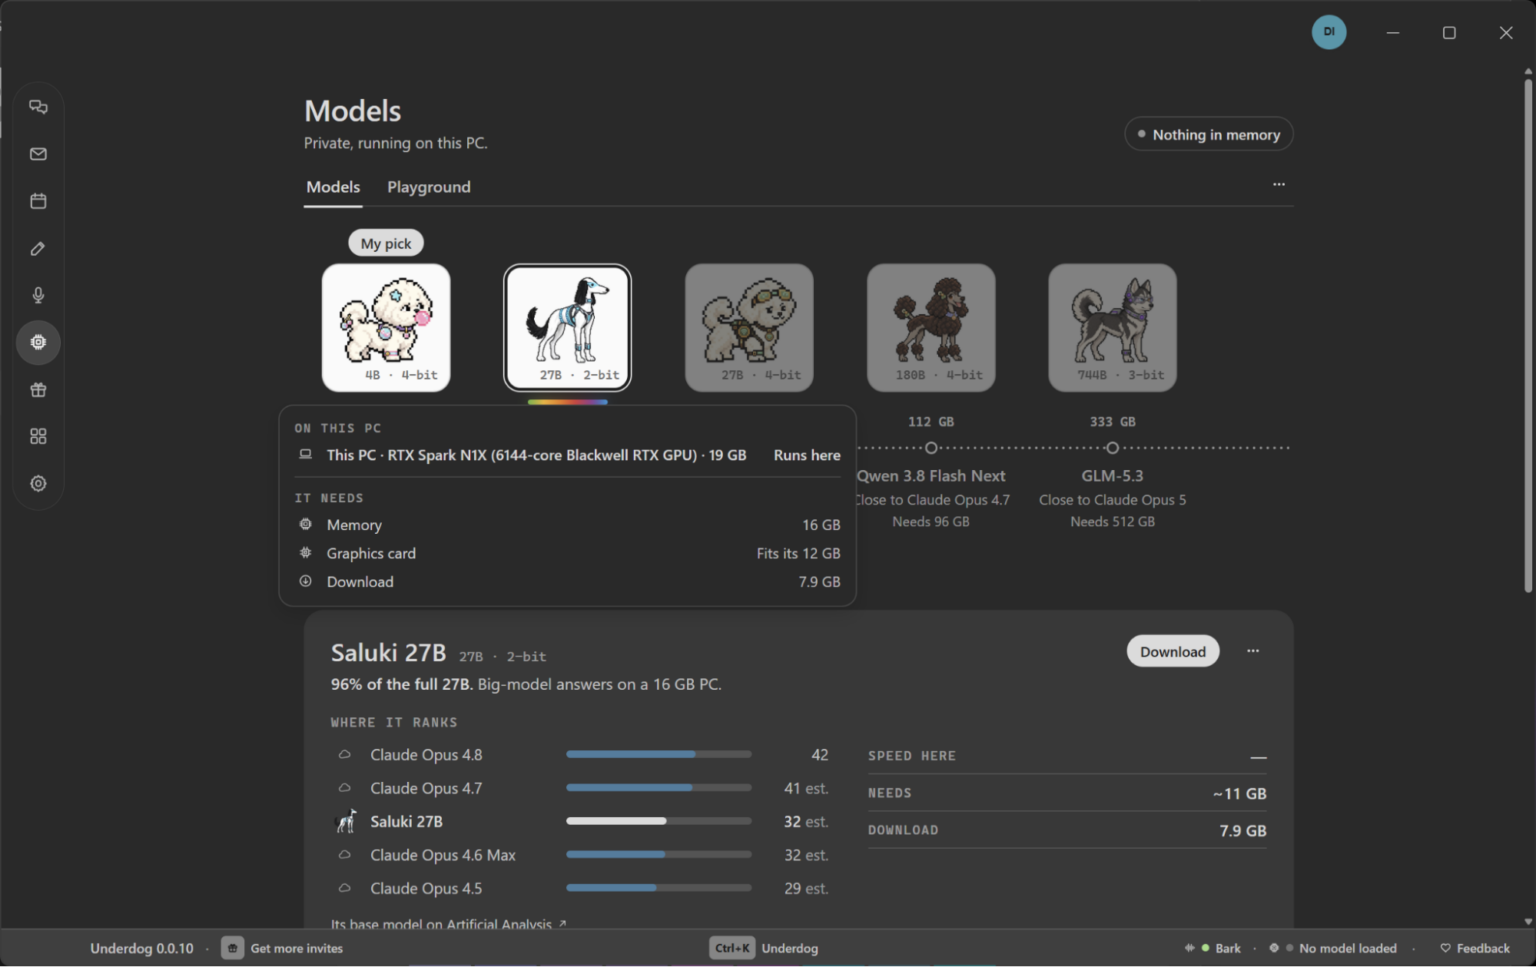
開発者や愛好家によるローカル エージェントの構築とカスタマイズをさらに支援するため、多くの RTX Spark ノート PC は、ブートローダーのロックが解除された状態で提供されます。
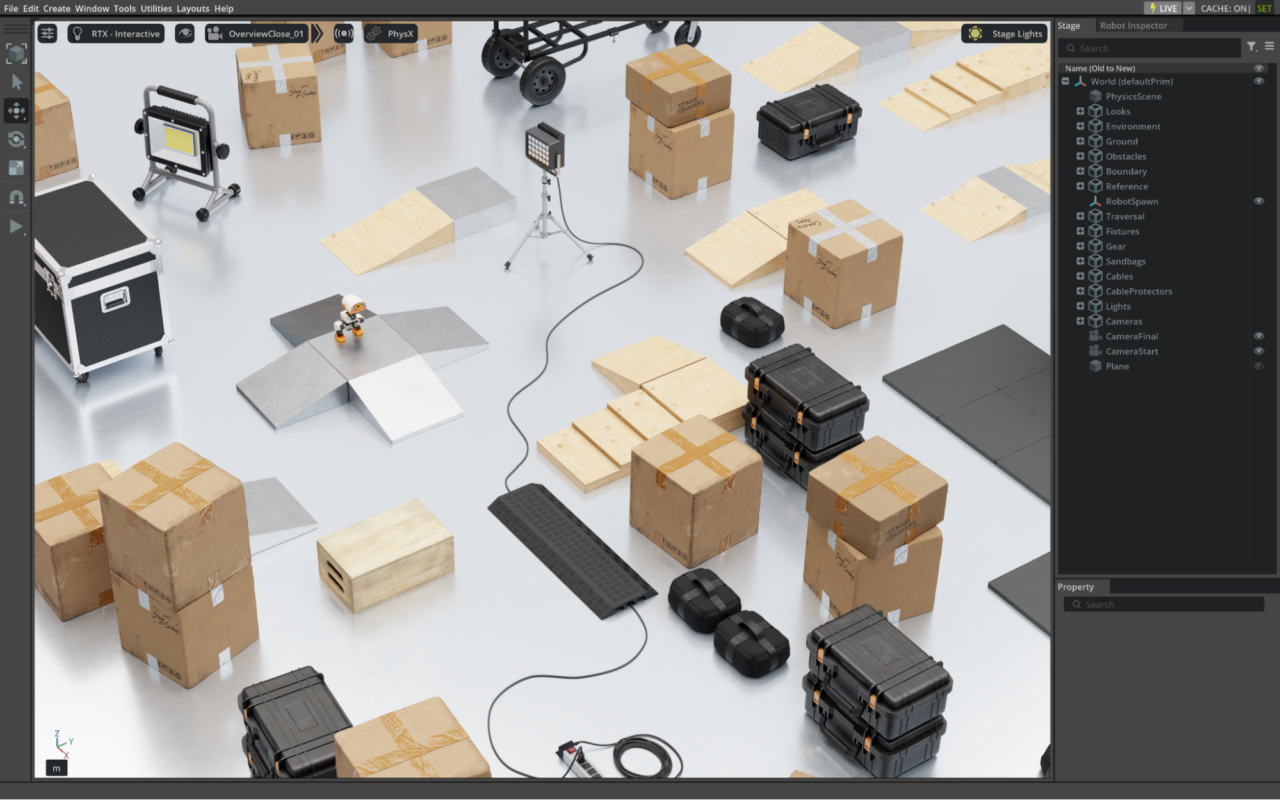
GTC の基調講演で、NVIDIA の創業者/CEO であるジェンスン フアン (Jensen Huang) は、RTX Spark 上で動作する AI エージェントを用いて、NVIDIA Isaac Lab、Hermes Agent、Nemotron 3.5 Bolt 74B により Hugging Face の Microduck ロボットをトレーニングする方法を披露しました。
ASUS、Dell Technologies、HP、Lenovo、Microsoft、MSI のノート PC は現在販売中で、Acer からも近日中に登場する予定です。
RTX Spark の詳細をご覧いただき、最新の RTX Spark プレイブックを活用して使い始めましょう。
DGX Spark が開発者の構築の可能性を広げる
Nemotron 3.5 Bolt 74B 24GB、Qwen3.8 27B、Gemma 4 26B-A4B などのモデルを実行できる、新しい DGX Spark 64GB システムが、10 月 23 日 (金) からパートナー各社より順次発売されます。
ワークロードにさらに大きな容量が必要になった場合、開発者は内蔵の NVIDIA ConnectX-7 ネットワークと NVIDIA Sync Cluster Assistant を通じて、複数の DGX Spark システムを接続できます。これにより、Qwen 3.8 Flash Next、DeepSeek v4 Flash 0731、GLM 5.3 Flash などの高度なコーディング モデルを実行できます。
DGX Spark は、手動構成による最大 8 台のクラスターをサポートするようになり、より大きなモデル、より長いコンテキスト、複数のエージェントの同時実行、分散開発を可能にします。1 つのクラスターをバックエンドとして共有し、各開発者が同じモデルに対して同時にセッションを実行する、小規模なチームに最適です。1 TB の統合メモリを提供し、GLM 5.3 のようなフロンティアクラスのモデルを実行するのに十分な容量を備えています。
DGX Spark クラスターのプレイブックを活用して使い始めましょう。
NVIDIA Sync Model Launcher も今月後半に提供される予定です。単体の DGX Spark やクラスターでローカル AI を簡単に利用できるようにします。数回のクリックで、Model Launcher が構成に適したモデルとコンテナをダウンロードし、モデルを OpenCode に接続します。さらに、DGX Spark Skills を自動的に読み込み、トラブルシューティング、デバイスのメンテナンス、公式ドキュメントへのアクセス、その他のワークフローに関するガイダンスを提供します。
DGX Spark の 10 月のソフトウェア アップデートでは、新しい Wi-Fi Assistant が追加され、DGX Spark がアプライアンス モードで動作している際に、ユーザーがネットワークを切り替えられるようになります。また、DGX Spark Skills は、トラブルシューティングやデバイスのメンテナンスについて、ワークフローに即したガイダンスを、OpenCode を通じて NVIDIA Sync に直接提供します。
DGX Spark システムは、Acer、ASUS、Dell Technologies、GIGABYTE、HP、Lenovo、MSI、NVIDIA から直接購入できます。
DGX Station がデスクにフロンティア インテリジェンスをもたらす
より大規模なチーム向けに、DGX Station は 748 GB のコヒーレント メモリと最大 20 ペタフロップスの AI 性能を提供します。開発者は GLM 5.3 などの高度なモデルを実行し、クラウド モデルに匹敵する速度で 30 人を超えるユーザーにサービスを提供できます。さらに規模を拡張するため、NVIDIA Sync が DGX Station に対応し、Linux ベースの 2 台のシステム間の接続を簡素化します。
Absolute Security、Splunk by Cisco、Fleet Device Management、Microsoft Intune、Perforce Puppet、Progress Software Chef、Tanium との新しい統合により、IT チームは、企業のセットアップ、管理、適合性確認のプロセスを通じて DGX Station システムを管理できます。これにより、最初のトークンが生成されるまでの時間 (TTFT) を最小限に抑えながら、承認の迅速化と展開リスクの低減を図ります。
今後登場する Windows ベースのシステムにより、開発者は、プロフェッショナル アプリケーションを活用し、NVIDIA RTX PRO GPU 上で実行され、NVIDIA GB300 システム上で大規模言語モデル (LLM) を動作させるエージェントから操作されるワークフローを、すべて 1 台のマシン上で構築できます。
システム メーカーのパートナー各社から 12 月に登場する予定の DGX Station for Windows は、企業がすでに利用しているアプリケーションや動作環境へとローカル AI を広げます。エンジニアは、同じシステム上の AI モデル、ツール、エージェントにアクセスしながら、Windows ネイティブのソフトウェア内でローカル モデルやエージェントを実行できます。
DGX Station for Windows は、AI を活用した設計、シミュレーション、検証、エンジニアリングの自動化に向けて、nTop、Dassault Systèmes、Keysight Technologies、MathWorks、Rockwell Automation、Siemens、Synopsys、Unity、Altera の製造業向けアプリケーションをサポートする予定です。ユーザーは、Hermes Agent、Perplexity、Aible を用いたエージェントをオンプレミスで実行し、企業環境でエージェントによる制御を行えるようになります。
このローカルで制御可能なコンピューティングの仕組みは、ロボティクスにも広がります。DGX Station は、ロボティクス チームにポストトレーニング、シミュレーション、評価のための専用の演算能力を提供し、共有インフラの利用を待つことなく、反復サイクルを短縮します。
NVIDIA は、GPT-6 Astra、NVIDIA Isaac Lab、Isaac Lab-Arena、Cosmos を NVIDIA DGX Station で活用できる、3 つのオープンソースのリファレンス ワークフローを公開しました。開発者は、これらを用いて強化学習により GR00T 1.7 モデルを改良し、器用な操作スキルをトレーニングし、合成データ生成に向けの Cosmos 世界モデルをポストトレーニングできます。
NVIDIA Cloud Functions は、Linux ベースの DGX Station 向けに早期アクセスで提供される予定です。チームは、ローカル モデルのエンドポイントを共有カタログに登録し、単一の OpenAI 互換のエントリー ポイントを通じてアクセスできます。
開発者はアプリケーション コードを変更せずにエンドポイントの背後にあるモデルをアップグレードでき、チーム メンバーはマシンに直接アクセスすることなく共有モデルを利用できます。これにより、DGX Station は、チームのためのローカルで制御可能な推論サービスになります。
DGX Station は、AI ファクトリー開発にローカルでの反復作業をもたらします。GTC Berlin の展示会場で NVIDIA は、DGX Station 上で動作する DSX OS をプレビュー公開し、インフラ全体が利用可能になる前に AI ファクトリーの運用をシミュレーションします。別のデモでは、DGX Station システムが、30 人を超えるソフトウェア開発者向けのローカル トークン ファクトリーを支える様子を紹介する予定です。
DGX Station システムは、ASUS、Dell Technologies、GIGABYTE、HP、MSI、Supermicro、Exxact から出荷が開始されています。DGX Station for Windows システムは、ASUS、Dell Technologies、GIGABYTE、HP、MSI、Supermicro から年内に出荷が開始される予定です。
RTX Spark 向けに最適化された新しいローカル コーディング モデル Recursive Flint を紹介
フロンティア AI 研究所の Recursive Superintelligence は、高速かつ正確なコーディング向けに構築されたローカル LLM、Recursive Flint を公開しました。総パラメータ数 400 億、アクティブ パラメータ数 25 億の Mixture of Experts モデルである Recursive Flint は、高速な推論を実現し、SWE-Bench Pro v2、Terminal-Bench 2.1、SWE-bench verified などのエージェント型コーディングのベンチマークでも優れた性能を発揮します。
Recursive Flint は、大規模な自動 AI 研究のためのシステムである Recursive の Eureka Machine を用いて構築されました。このシステムは、アイデアの提案、実装、アイデアを検証する実験の実行、結果に基づく次の試行の判断という、研究の全サイクルを自動化します。これにより、モデルの重みを変更することなく、RTX Spark 上での Flint の生成速度を 55% 向上させる専用カーネルが作成されました。
開発者は、Apache 2.0 ライセンスの下で Hugging Face からオープン ウェイトをダウンロードし、RTX Spark、DGX Spark システム、GeForce RTX GPU、RTX PRO GPU 上でモデルを実行できます。開発者はまた、NeMo Automodel による教師ありファインチューニングと低ランク適応 (LoRa)、および NeMo RL によるグループ相対方策最適化 (GRPO) を通じて、モデルのポストトレーニングも行えます。
新しいモデルを公開初日からサポート
NVIDIA は、NVIDIA Nemotron Bolt E4B 4B、GLM、DeepSeek、Qwen、MiniMax、Liquid AI の LFM2.5-24B-A2B に加え、拡散モデル FLUX.3 Klein に対して、公開初日からモデル サポートを追加します。
Nemotron Bolt E4B 4GB は、わずか 4 GB のメモリに自然な会話とマルチターンのエージェント型スキルを収め、NVIDIA GeForce RTX GPU、NVIDIA Jetson デバイス、RTX Spark、DGX Spark 上で、高速なローカル音声アシスタント、対話型のゲーム キャラクター、組み込みインターフェイスを実現します。Bolt E4B 4GB は、10 月 23 日 (金) にリリースされます。
Black Forest Labs の FLUX 3 Image Klein は、生成と編集のための、56 億パラメータのオープン ウェイト画像モデルです。NVIDIA に最適化されたビルドにより、わずか 8 GB の VRAM を搭載した GeForce RTX GPU 上で実行でき、RTX 5090 GPU では 100 万画素の画像を約 4 秒で生成できます。
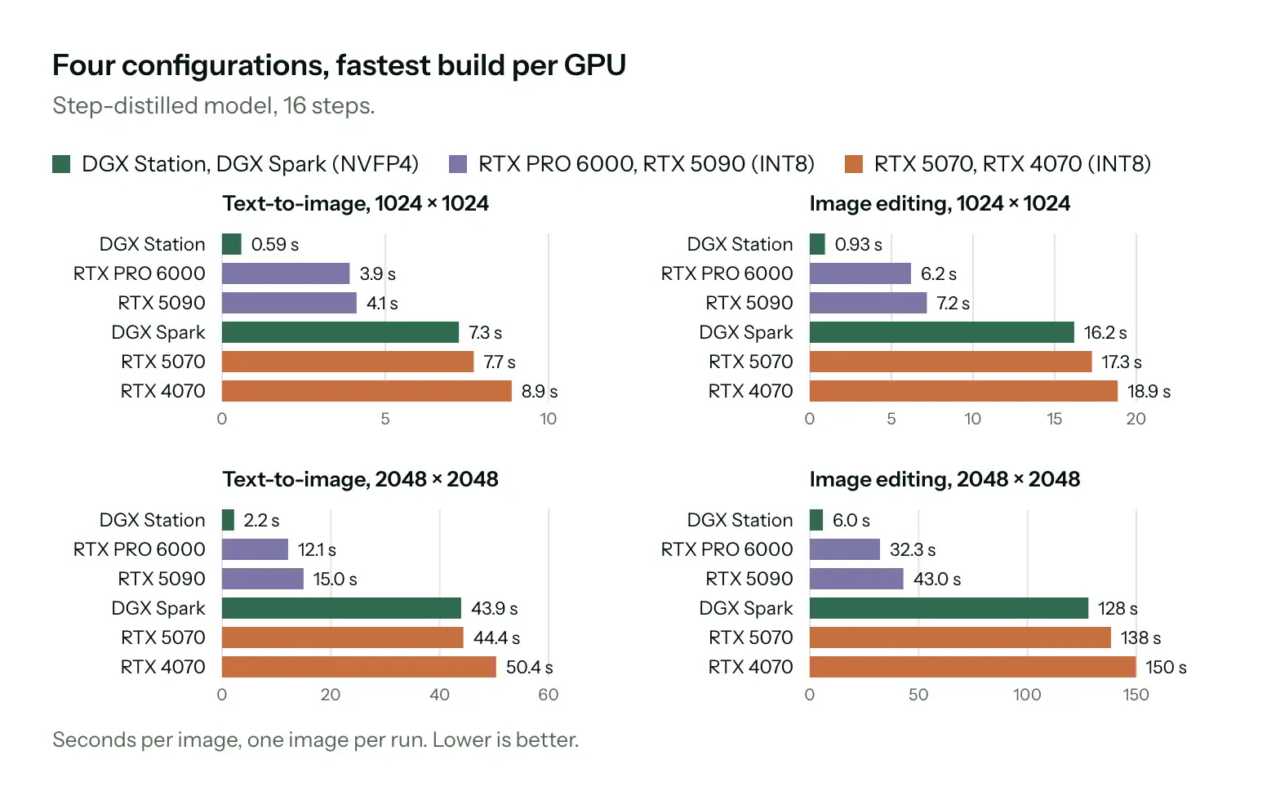
MiniMax M3.1 Flash は、NVIDIA DGX Station と DGX Spark 向けに構築された新しいオープン モデルで、長いコンテキストを扱う AI をデスクトップにもたらします。Liquid AI の LFM2.5-24B-A2B は、240 億のパラメータのうちトークンごとに 20 億のみをアクティブ化するオープン ウェイトのリーズニング モデルです。このため、ツール呼び出しを行うプライベートな AI エージェントを PC 上で直接実行できるほどの高速性を備えています。
さらに NVIDIA は、ローカル AI ハードウェア上の RAM 効率に最適化された新しいモデル チェックポイントのコレクションを公開しました。これにより、KV キャッシュのために十分なメモリを残しながら、フロンティアクラスのオープン モデルを実行できます。各チェックポイントは、フル精度に近い精度を維持しながら量子化されています。まず、単体の DGX Spark 128GB または RTX PRO 6000 向けの Qwen3.8-Flash-Next-FP4-Local と、2 台のシステム向けの GLM-5.3-Flash-FP4-Local から提供します。
開発者は、DGX Spark と RTX Spark の両方で、NeMo AutoModel を使用してモデルの公開初日からポストトレーニングを行えます。Nemotron Bolt E4B、Flux 3 Image Klein などのレシピ例も用意されています。
AI 推論を高速化
NVIDIA は、llama.cpp および vLLM のオープンソース コミュニティとの協力を継続し、ローカル ハードウェア上のエージェント型ワークロードを高速化しています。
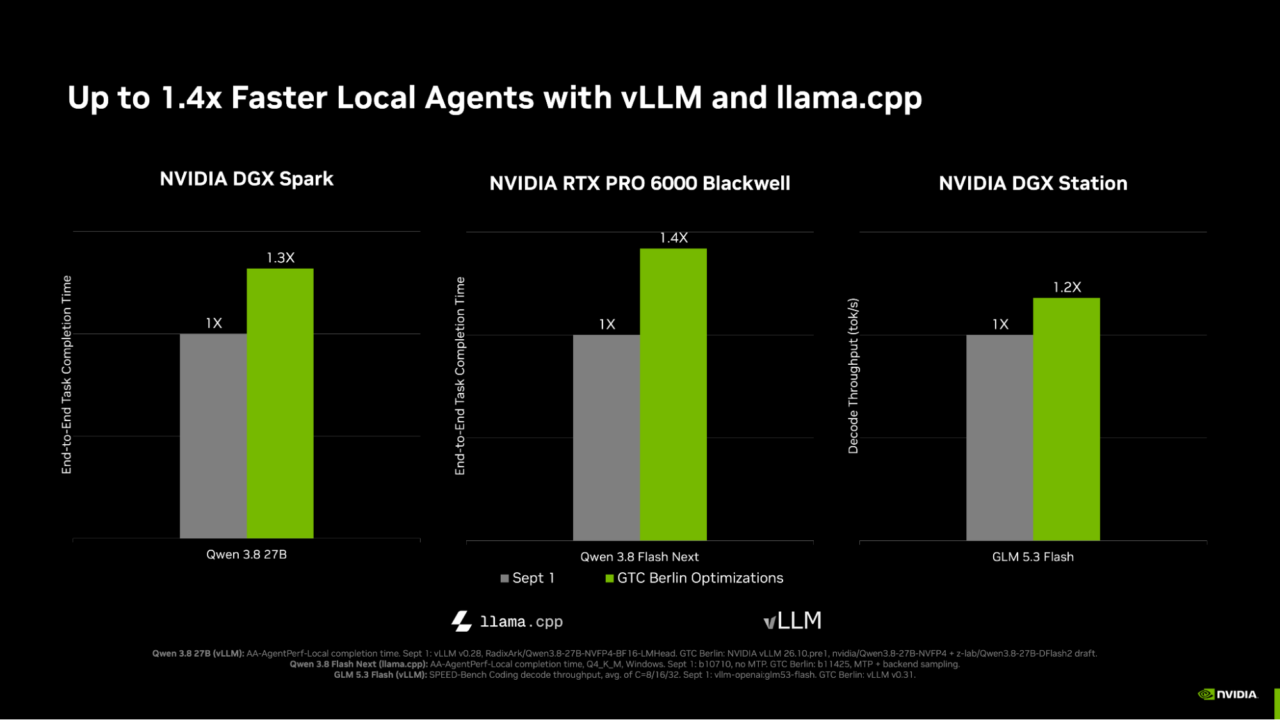
llama.cpp では、Qwen 3.8 Flash Next 向けに MTP を用いた投機的デコーディングを新たにサポートし、NVIDIA RTX PRO 6000 Blackwell 上で、エンドツーエンドのエージェント型タスクを最大 1.4 倍に高速化します。
vLLM では、より高速な投機的デコーディングと、Qwen の線形アテンション層向けの新しい FlashInfer プリフィル カーネルにより、DGX Spark 上で Qwen3.8 27B を用いたエージェント型タスクが最大 1.3 倍に高速化します。DGX Station 上では、GLM 5.3 Flash のスループットが最大 1.2 倍に向上します。
NVIDIA のローカル AI 推論レシピを参照して、これらの最新の最適化をお試しください。
X、Instagram、TikTok、Facebook で NVIDIA RTX Spark をフォローし、NVIDIA ローカル AI ニュースレターに登録して最新情報をご確認ください。また、LinkedIn と X で NVIDIA Workstation をフォローしてください。
ソフトウェア製品情報に関する注意事項をご覧ください。