
トークンにより、ローカル AI の有用性はますます高まっています。
AI エージェントが実験段階を経て一般に開発されるようになる中、ますます高性能なオープン モデルが小型化されて搭載可能なデバイスが増えつつあり、開発者にとってローカル実行可能な選択肢が広がっています。
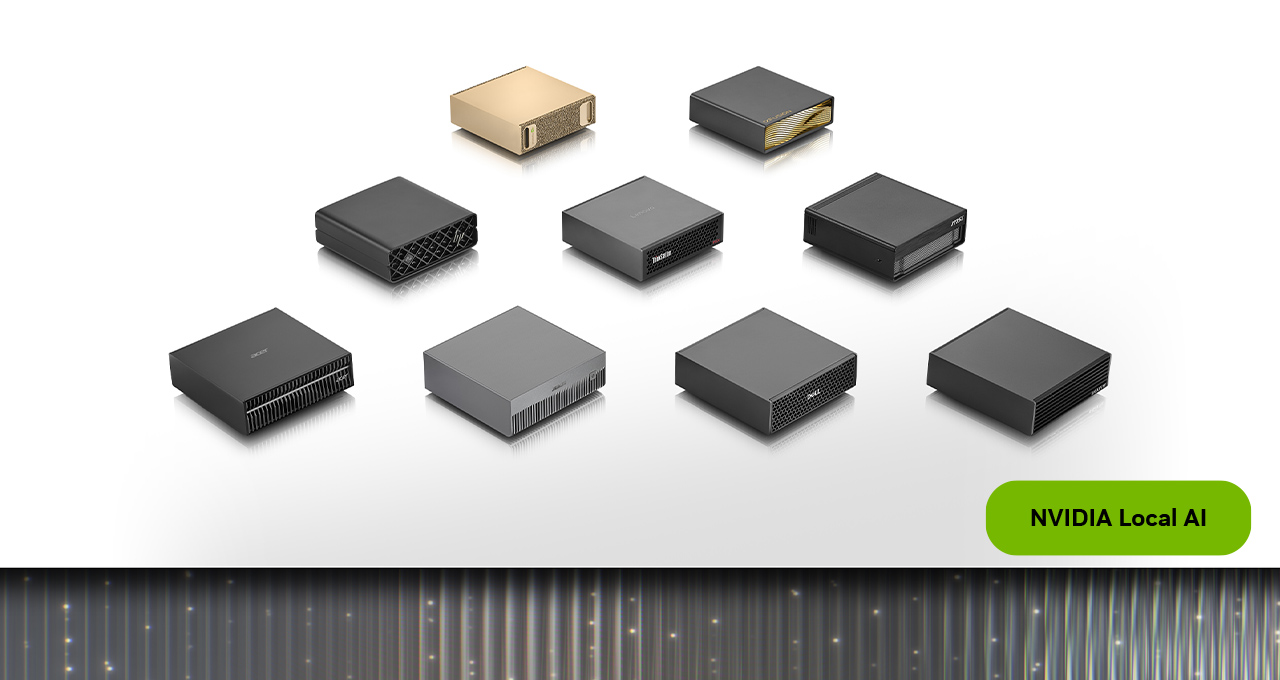
今月、64GB の統合メモリを搭載した NVIDIA DGX Spark が、主要メーカー パートナーである Acer、ASUS、Dell、Gigabyte、HP、MSI から発売されます。開発者、研究者、AI 愛好家は導入初日からすぐに、新しい構成を DGX OS および NVIDIA AI ソフトウェア スタックとともに利用できます。
この新しい SKU は、高性能なローカル エージェントをデバイス上で、クラウドに依存することなくプライベートに実行します。しかも、ワークロードが増加した場合、NVIDIA Sync Cluster Assistant を介して、2 台のユニットを追加の設定なしでクラスタリングできます。
パーソナル AI スーパーコンピューティングの新たな出発点
DGX Spark は、NVIDIA Grace Blackwell コンピューティング、統合メモリ、NVIDIA ConnectX-7 ネットワーク、および NVIDIA CUDA アクセラレーション対応の AI ソフトウェア スタックを 1 つのシステムに統合したもので、エージェント、推論、ファインチューニング、データ サイエンス、エッジ開発向けの完全なローカル AI プラットフォームです。
このコンパクトなパーソナル AI スーパーコンピューターは、あらゆるタスクでクラウド インスタンスに頼らずに、モデルと開発者独自のデータを使って実験できる場を提供します。
メーカー パートナーのみから発売される新しい 64GB 構成は、128GB モデルと同様に、GB10 Grace Blackwell スーパーチップ、DGX OS、および完全な NVIDIA AI ソフトウェア スタックを搭載しながら、手頃な価格帯に抑えています。最大 1,000 億パラメーターのモデルとそれらに基づいて構築されたエージェント アプリケーションを、デバイス上で完全にサポートします。
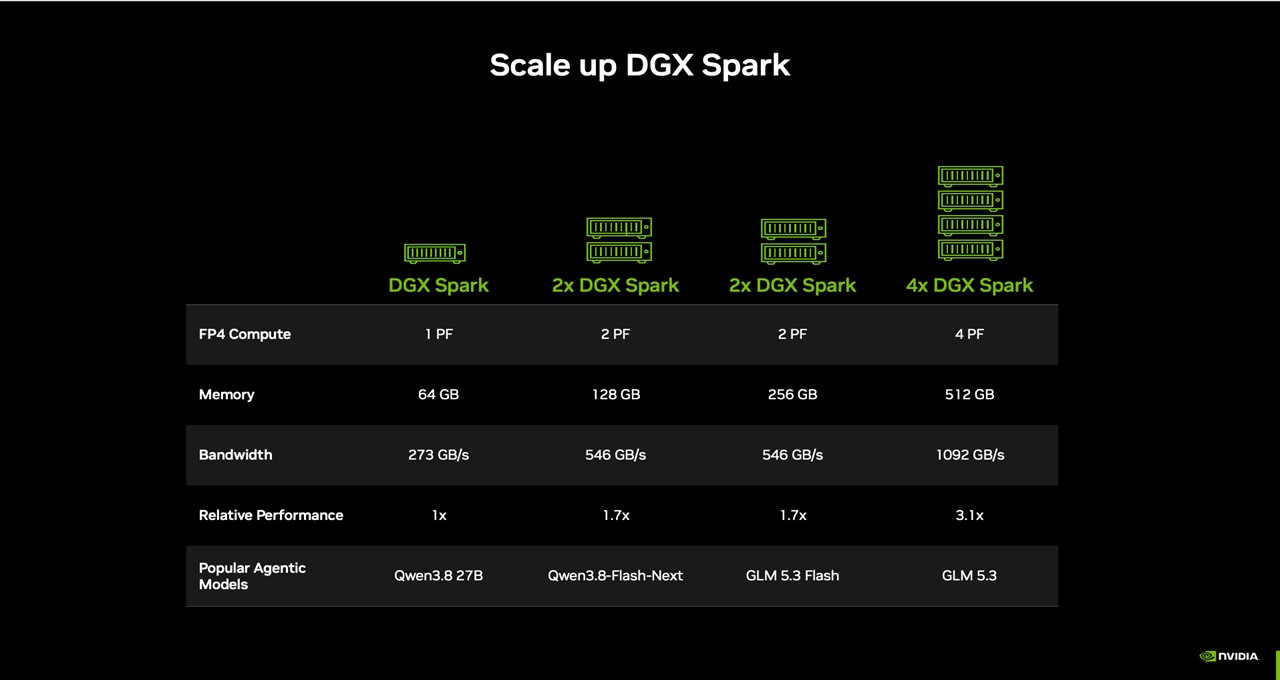
2 台の 64GB ユニットをクラスタリングすると、メモリ容量が 2 倍になるだけではありません。NVIDIA の Qwen 3.8 27B テストでは、クラスター化された 2 台の 64GB システムは、単一のシステムと比較して最大 1.7 倍のパフォーマンスを実現し、ワークロードの要求に応じてスケールし続ける余裕を生み出します。
DGX Spark は、導入初日からエージェント開発に利用できる状態で出荷されます。NVIDIA Agent Toolkit、CUDA-X AI ライブラリ、Nemotron オープン モデルのほか、Ollama、vLLM、CUDA 対応 PyTorch といった一般的なランタイムがすべて標準でサポートされており、電源投入からわずか数分でモデルを実行できます。
Blender は、このプラットフォームを最初にサポートする主要なクリエイター アプリケーション プロバイダーの 1 つであり、ダウンロード可能なプリビルド インストーラーを近日提供予定です。
NVIDIA Sync Cluster Assistant でスケールアップ
開発者は、現在のプロジェクトに必要なメモリ容量から開始し、マルチノード クラスターをシームレスにスケールできるように設計されたプラットフォーム上で、パイプラインの拡大に応じて、より大規模なワークロードに対応することができます。
すべての DGX Spark には、NVIDIA ConnectX-7 NIC が標準で搭載されています。さらに、2 台のユニットを QSFP ケーブルで直接接続することで、メモリを 128GB までプールし、モデルのサポートを最大 2,000 億パラメーターまで拡張でき、それと同時にメモリ帯域幅は 2 倍、パフォーマンスは最大 1.7 倍に向上します。
このマルチノード クラスターは、NVIDIA Sync アプリによってシームレスに構成されます。クラスター アシスタント機能が、接続されたユニットを検出し、デバイス構成を検証し、ConnectX-7 ネットワークを構成するため、開発者はインフラストラクチャではなく、本来の作業に集中できます。すべてのノードで同じ NVIDIA ソフトウェア スタックが実行されるため、1 台から 2 台にスケールする際に再構成は不要です。
また、今月末には NVIDIA Sync Model Launcher も提供される予定で、数回クリックするだけの簡単操作でローカル AI を実行できるようになります。開発者が単一の DGX Spark システムまたはクラスター上で Qwen3.8 27B をダウンロードして起動すると、NVIDIA Sync は接続されたデバイス間で実行されるようにモデルを構成し、ユーザーのノート PC からアクセスできるようにします。このランチャーは、モデルを使用できるように OpenCode のセットアップも行うため、開発者はブラウザー上でコーディングを開始できます。
DGX Spark の開発者ユースケース
新しい 64GB 構成の DGX Spark は、導入初日から実務を支えます。最大 1,000 億パラメーターのモデルをデバイス上で完全に実行できるため、メモリ容量に収まるモデルであれば、単一のシステムから始めることができます。あるいは、さらに多くのメモリと計算能力を必要とするワークロードの場合、NVIDIA Sync Cluster Assistant を使用して複数の DGX Spark システムを接続します。
以下は 3 つのワークフロー例です。
- AI エージェントの常時稼働: コード レビューやドキュメント分析、マルチステップ タスクをいつでも実行できるように、DGX Spark 上でコーディング エージェントやリサーチ エージェントを常時稼働させる。クラスタリングすることで、より大規模なモデル、より長いコンテキスト ウィンドウ、または複数エージェントの同時実行に必要な追加の容量が得られます。
- 普段使用する PC 上の AI アプリの強化: ノート PC またはデスクトップ PC 上で、エージェントやクリエイティブ アプリケーションを使用しながら、DGX Spark 上で言語生成モデルや画像生成モデルを実行する。モデル推論は DGX Spark が処理するため、PC が他の作業に解放されます。
- 作業が増大した場合のスケール: より大規模なモデルやより長いコンテキスト ウィンドウの実行、またはエージェントの同時リクエストなど、単一のタスクを 1 台のユニットで処理しきれない場合、NVIDIA Sync Cluster Assistant を介して 2 台の DGX Spark 64GB システムを 200 GbE ファブリックで接続することで、メモリを 128GB までプールする。1 台のユニットで実行されていたワークフローは、ソフトウェア環境の再構成不要で 2 台のユニットにスケールされます。
DGX Spark をご体験ください
DGX Spark 64GB は、10 月 23 日 (金) に Acer、ASUS、Dell、Gigabyte、HP、MSI から発売されます。価格は 4,999 ドルからです。
始めるには:
- サポートされている推論フレームワーク (llama.cpp、Ollama、vLLM、または LM Studio) をダウンロードします。
- ワークフローの推奨ローカル モデルをダウンロードします。
- 2 台のユニットにスケールするには、NVIDIA ConnectX-7 ポートを介して接続し、NVIDIA Sync Cluster Assistant を起動します。それにより、ネットワークの構成とワークロードのルーティングが自動的に行われます。
DGX Spark のエージェント型 AI プレイブックについては、build.nvidia.com の NemoClaw、OpenClaw、Hermes Agent、および OpenShell ページをご覧ください。
#ICYMI: NVIDIA ローカル AI に関するその他の最新情報
build.nvidia.com/spark で DGX Spark プレイブックをご覧ください。64GB デバイス向けに以下のプレイブックが近日公開予定です。
- Serve LLMs With vLLM
- Run OpenClaw With a Local LLM
- Connect Multiple DGX Sparks for Distributed Workloads
新しい NVIDIA RTX Spark 搭載 Windows PC が、Acer、ASUS、Dell、HP、Lenovo、Microsoft、MSI から今月発売されます。今後の最新情報を受け取るには、RTX Spark ニュースレターにご登録ください。
Alibaba の Qwen-Image-2.1 は、画像生成と画像編集を統合した軽量なオープンウェイト モデルです。NVIDIA RTX GPU、DGX Spark、DGX Station 上でローカル実行でき、クリエイター自身のハードウェアで画像を生成・調整する方法が広がります。
X、Instagram、TikTok、Facebookで NVIDIA RTX Spark をフォローしましょう。また、NVIDIA ローカル AIニュースレターにご登録いただくと、最新情報を入手できます。LinkedIn と X で NVIDIA Workstation をフォローしてください。
ソフトウェア製品に関する免責条項をご覧ください。