
システム パフォーマンス、効率的なインフラのスケーリング、そして継続的なソフトウェア最適化は、AI 推論の経済性を左右する重要な要素です。システム パフォーマンスが向上すれば、生成されるトークン数が増え、収益も増加します。効率的なスケーリングとは、ハードウェアの追加に伴ってスループットが比例的に向上し、大規模なユーザーに対応するために必要なリソースが少なくて済むことを意味します。継続的な最適化は、インフラへの投資からより多くの価値創出へとつながります。
これら 3 つの要素の根底にあるのは、プラットフォームの汎用性です。同じインフラで、トレーニングから推論、レコメンダーからリーズニング、言語処理からビデオ処理まで、あらゆるモデル、あらゆるワークロードを実行でき、高い利用率を維持できます。
NVIDIA プラットフォームは、これらすべてを最適化するために専用設計されており、本日公開された MLPerf Inference v6.1 の結果がそれを証明しています。
- NVIDIA Vera Rubin NVL72 システムが優れたパフォーマンスで登場: 最初の MLPerf Inference プレビュー提出において、NVIDIA Vera Rubin NVL72 は GB300 NVL72 よりも最大 3.7 倍優れたスループットを実現。
- NVIDIA GB300 NVL72 は優れた効率でスケーリング: 4 台の GB300 NVL72 ラックにわたる 288基の GPUの提出は、99% のスケーリング効率を達成し、スループットは単一ラックのベースラインからほぼ線形に増加。
- 継続的なソフトウェアの最適化によりパフォーマンスが向上: NVIDIA の MLPerf Inference v6.1 提出におけるソフトウェアの最適化により、v6.0 と比較して最大 1.6 倍の高いパフォーマンスが実現。v6.1 の提出後も最適化が継続され、さらなるパフォーマンスの向上も実現。
AI インフラに関する意思決定を行う組織にとって、パフォーマンス、スケーリング効率、およびソフトウェアの速度は、長期的な推論の経済性を決定する重要な考慮事項です。
Vera Rubin NVL72 が優れたパフォーマンスで MLPerf Inference デビューを果たす
NVIDIA は、MLPerf Inference v6.1 スイートの最も要求の厳しい 2 つのベンチマーク、DeepSeek-R1 と Qwen3-VL において、Vera Rubin NVL72 プレビュー結果を提出しました。
Vera Rubin NVL72 は、NVIDIA Dynamo オープンソース推論フレームワークと vLLM を使用して、オフライン、サーバー、およびインタラクティブ シナリオ全体において、Qwen3-VL で GB300 NVL72 よりも最大 3.7 倍高いスループットを実現します。DeepSeek-R1 では、NVIDIA TensorRT-LLM ライブラリを使用すると、スループットが GB300 NVL72 よりも最大 2.5 倍高くなります。これらの初期の結果は、NVIDIA のイノベーションの加速ペースと、継続的なソフトウェア最適化によってパフォーマンスがどのように向上するかを示しています。
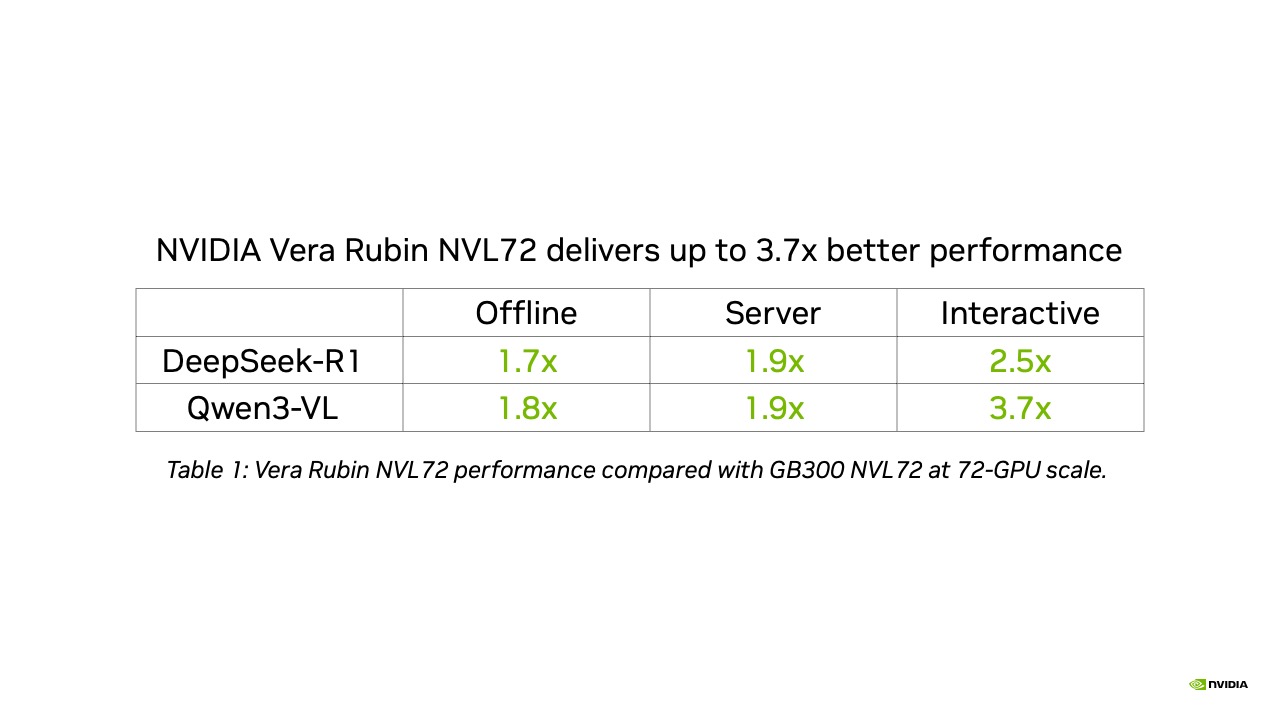
この性能は、各 Vera Rubin NVL72 ラックが、GB300 NVL72 ラックと比較して、トークンあたりのコストを低減しつつ、より多くのトークンを生成し、より多くのユーザーにサービスを提供し、より多くの収益を生み出すことを意味します。
これらの結果は、ハードウェアとソフトウェアにわたるフルスタックの協調設計を反映したものです。Vera Rubin の強化された Tensor コアと Transformer Engine は、推論のプリフィルおよびデコードの両段階を高速化します。同時に、NVFP4 精度がモデルの重み、アテンション、KV キャッシュ全体でのメモリ使用量を削減し、出力品質の低下を最小限に抑えながらスループットを向上させます。
Vera Rubin を用いた提出では、DeepSeek-R1 や Qwen3-VL といったモデルを支える Mixture-of-Experts (MoE) 層において、最大限の効率を実現するために、プリフィルとデコードを分離する分離サービングや、大規模なエキスパート並列処理が積極的に活用されました。
第 6 世代 NVIDIA NVLink および NVLink Switch を搭載し、一般的なイーサネットと比較して 10 倍のパケットレートと 3 分の 1 のレイテンシを実現する NVL72 スケールアップ ドメインは、こうした技術をラック規模で有効に機能させるためのインターコネクト基盤を提供します。
この協調設計の取り組みは、NVIDIA のパートナーエコシステムにも広がっており、Nebius も Vera Rubin NVL72 によるプレビュー結果を提出し、優れた性能を実証しました。
複数のステップにわたってリーズニング、計画、実行を行う AI エージェントは、推論性能の測定方法を大きく変えつつあります。こうした変化を捉えるために設計されたベンチマーク SemiAnalysis の AgentX などにおいて、Vera Rubin NVL72 はプレビュー テストで GB300 NVL72 の 30 倍という優れた性能を記録しました。さらに、今後登場する MLPerf Endpoints ベンチマークは、従来のスループット重視のベンチマークでは捉えきれなかったエージェント型推論ワークロードに対し、標準化された測定手法をもたらすことになります。
NVIDIA GB300 NVL72:優れた効率性でスケールアップを実現
スケーリング効率‐追加した GPU がどれだけ効果的にスループットの向上に寄与するかは、AI インフラの生産性を測る重要な指標です。NVIDIA は、ラック内での広帯域かつ低遅延なスケールアップ インターコネクト、ラック間の広帯域ネットワーク、そしてノード間での効率的なリクエスト オーケストレーションを組み合わせることで、この高い効率性を実現しています。
NVIDIA による DeepSeek-R1 (DSR1) の提出では、GB300 NVL72 の 1 ラック構成 (GPU 72 基) から 4 ラック構成 (GPU 288 基) へと規模を拡大した際、オフライン シナリオにおいて 99% というスケーリング効率を達成しました。つまり、追加したハードウェアの規模にほぼ比例してスループットが向上したことになります。
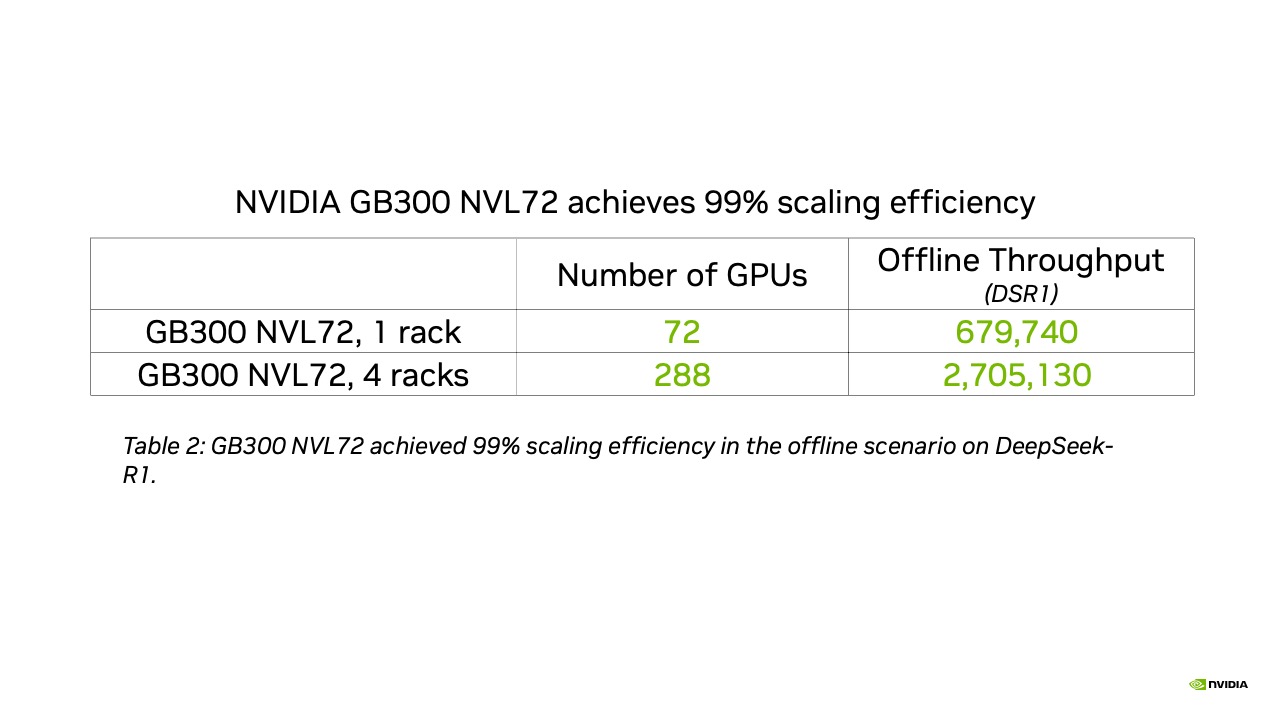
GPU の数が増えても、それに比例してスループットも自動的に増加するわけではないため、スケーリング効率が重要です。GPU 数をほぼ 2 倍に追加してもスループットが 1 桁のパーセントしか向上しない場合、インフラのコストがパフォーマンスの向上をはるかに上回ります。アーキテクチャ、相互接続、ソフトウェアはすべて同時に拡張する必要があります。
GB300 NVL72 は、WAN 2.2 テキストからビデオへのベンチマークでもラックスケール効率を実証し、ビデオあたり 5.7 秒で 1 秒あたり 0.65 の 720p ビデオに達しました。これは、単一ノードに比べて 9 倍高いスループットと 7.5 倍低いレイテンシを実現します。
ソフトウェアの最適化が継続的な性能向上を実現
NVIDIA のプラットフォームは継続的なソフトウェア開発が行われており、性能や機能の向上が図られています。
バージョン 6.1 では、Qwen3-VL における GB300 NVL72 の性能が、バージョン 6.0 の結果と比較して最大 1.6 倍に向上しました。この性能向上は、KV キャッシュ精度の低減、カーネル融合の追加、カーネルの改良、そして vLLM と NVIDIA Dynamo を活用した分離サービングの導入によって実現されました。
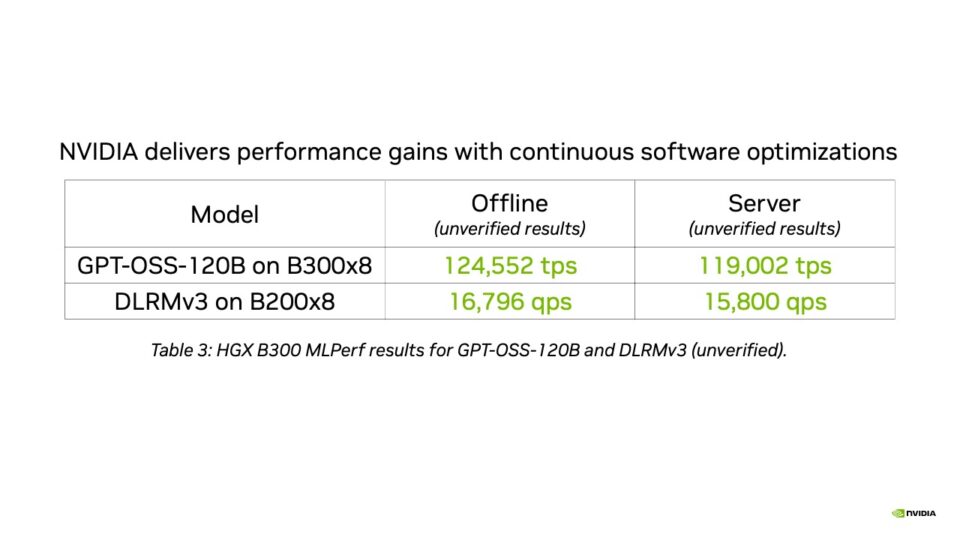
バージョン 6.1 の提出期限後もソフトウェアの最適化は継続して行われました。MLCommons による検証はまだ行われていませんが、GPT-OSS-120B および DLRMv3 に関する提出後の結果においても、さらなる性能向上が確認されています。
あらゆる規模で AI 推論を実現
NVIDIA Grace Blackwell および Vera Rubin NVL72 プラットフォームでの成果に加え、NVIDIA は新たに導入された Edge-Agentic ベンチマークにおいて、Qwen3.6-27B と NVIDIA TensorRT Edge-LLM を使用した Jetson AGX Thor の測定結果を提出しました。
NVIDIA のパートナー エコシステムも幅広く参加し、19 社のパートナー (うち 8 社はマルチノードの Blackwell NVL72 システムを使用) が優れた性能を実証しました。参加企業には、ASUS、Azure、Cisco、CoreWeave、Crusoe、Dell Technologies、富士通、Giga Computing、HPE、Inventec、Lambda、MiTAC Computing、Nebius、Oracle Cloud Infrastructure、Quanta Cloud Technology、Red Hat、ScitiX、Supermicro、Wiwynn が含まれます。
NVIDIA は、小型のエッジ デバイスから最大規模の AI ファクトリーに至るまで、プラットフォーム アーキテクチャの年次更新、継続的なソフトウェアの改良、そして大規模展開を可能にするエコシステムを通じて、テクノロジ スタック全体で性能向上を推進し続けています。
詳細についてはNVIDIA Vera Rubin プラットフォームをご覧ください。