
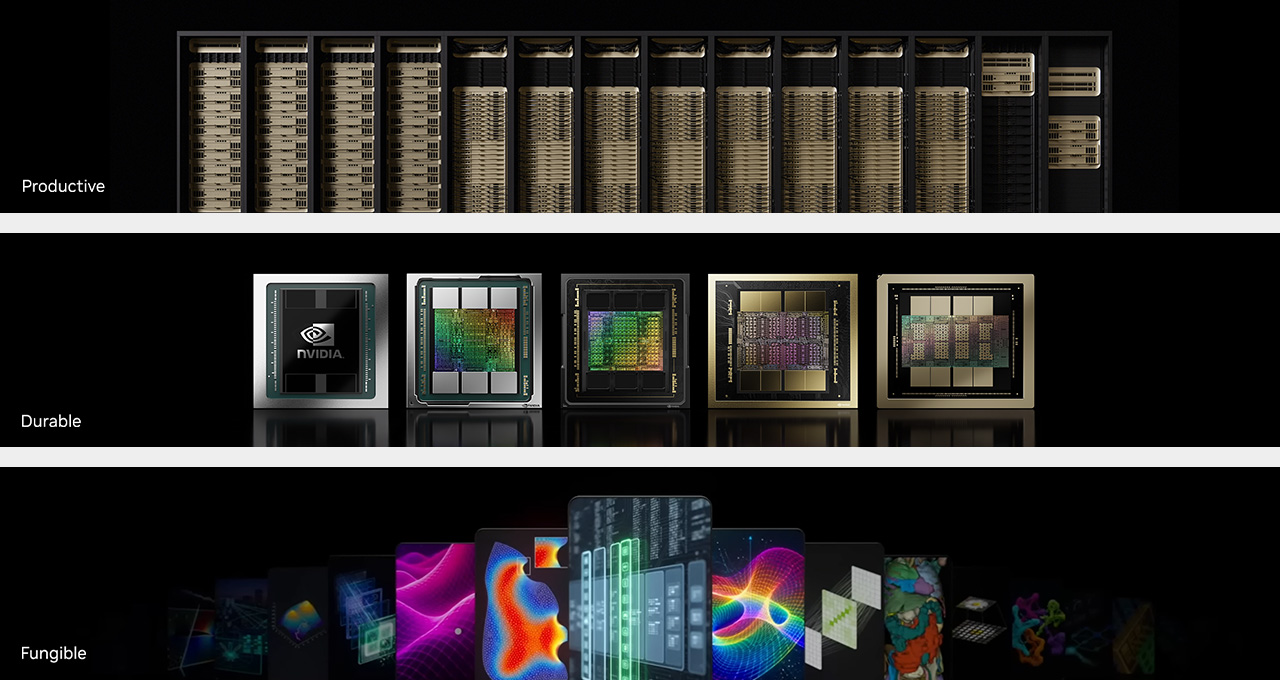
AI ファクトリーは、メガワット単位、さらにはギガワット単位の消費電力規模で構築されます。1 メガワットにつきファクトリーのコストはおよそ 6,000 万ドルであり、AI ファクトリーの運営事業者がそれほどの巨額投資に踏み切るには、投資収益の見通しが明確でなければなりません。AI ファクトリーの収益を左右するのは、主に以下の 3 つの要素です。
- 収益力: ファクトリーで生成可能なすべてのトークンを販売した場合に、1 年間で得られる収益
- 耐用年数: AI ハードウェアが収益を生み出し続ける期間
- 需要: 生成するトークンに対する需要の大きさ
ある要素の強みが、別の要素の弱みを完全に補うことはできません。収益力が高くても、生成したトークンの一部しか販売できなければ、その能力に価値はほとんどありません。需要が高くても、わずか 1 年でフル稼働できなくなれば意味がありません。さらに、これら 3 つの要素は互いに独立しているわけでもありません。より多くの種類のワークロードを処理できるファクトリーであるほど需要が高まり、長年にわたって収益を上げ続けることができます。
NVIDIA の AI ファクトリーは、これら 3 つの要素すべてを最大化するように設計されています。その特徴は以下のとおりです。
- 高い生産性: メガワットあたりのスループットを最大化し、トークンあたりのコストを最小限に抑えることで、収益力を最大化します。
- 高い耐久性: NVIDIA の GPU やシステムは、出荷後も長年にわたり収益を生み出し続けるため、ファクトリーの耐用年数を延ばします。
- 高い汎用性: あらゆる段階、あらゆる場所、あらゆる種類の AI を実行できるだけでなく、AI を一切含まない多くのワークロードにも処理できるため、対応可能な需要の範囲が広がります。
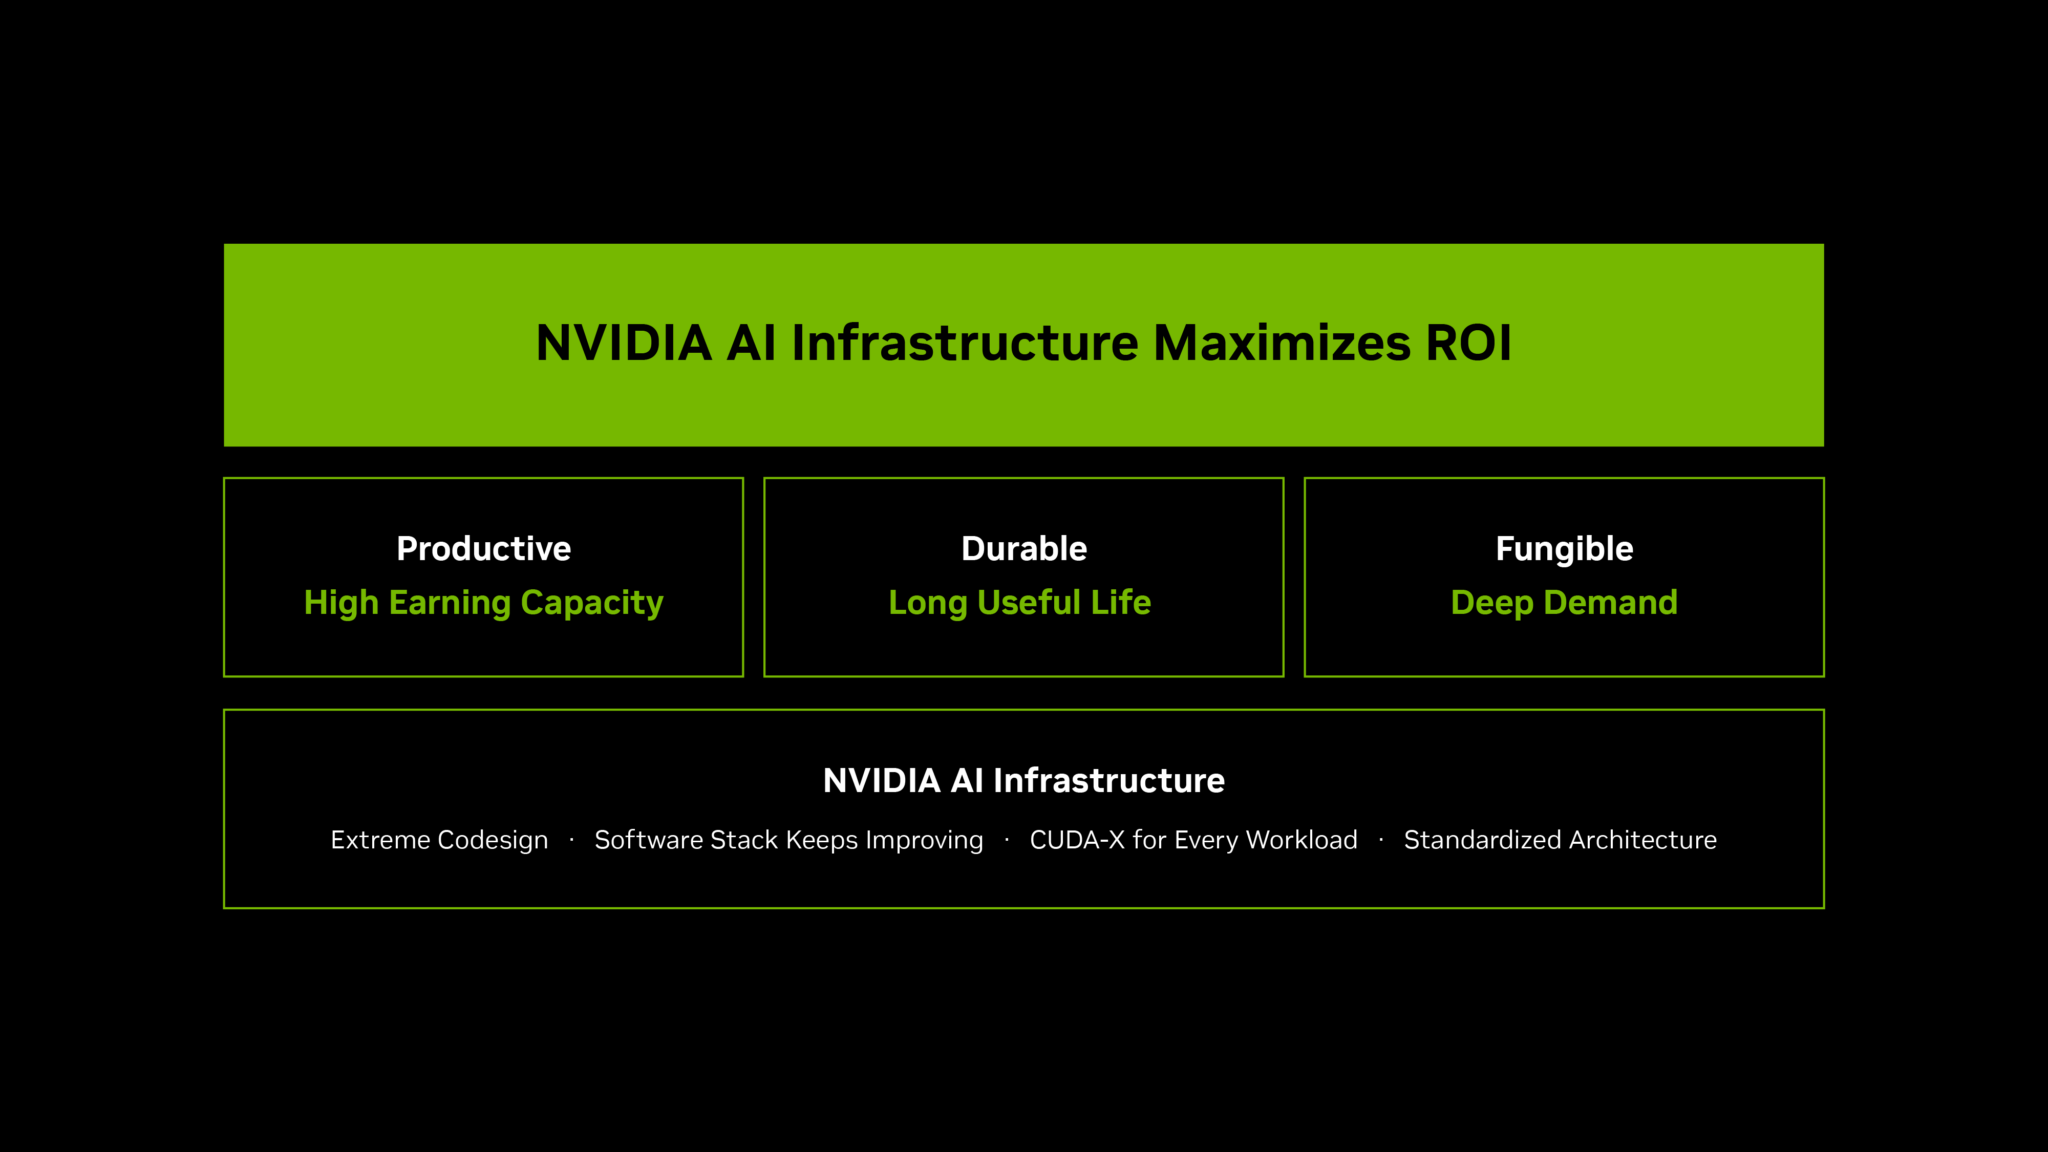
フルスタックにわたるエンジニアリングの協調設計によって AI ファクトリーのスループットが最大化されており、ソフトウェアを継続的に最適化することで導入済みのハードウェアは出荷後も長年にわたり高い生産性を維持します。また、NVIDIA CUDA-X ライブラリを活用して、ファクトリーはあらゆるアクセラレーション対応ワークロードを実行できます。さらに、標準化されたアーキテクチャにより、検証済みのリファレンス デザインから展開が可能で、あらゆる事業者がこれらの機能を容易に展開できます。
生産性: メガワットあたりのトークン生成数は最大、トークンあたりのコストは最小
電力は AI ファクトリーにおける制約要因です。そのため、1 秒間のメガワットあたりトークン生成数が収益力を左右する指標となります。一定の電力枠内でより多くのトークンを生成できれば、その分収益も増加します。また、トークン単価が低ければ、利益率の向上につながります。
SemiAnalysis の AgentX のデータによると、NVIDIA Vera Rubin NVL72 システムは、NVIDIA GB300 NVL72 と比較して、メガワットあたりのスループットが 30 倍以上高く、DeepSeek V4 Pro モデルでは 100 万トークンあたりのコストが最大 45 倍低くなっています。これほどの大幅な性能向上は、モデルやワークロードからソフトウェア、さらにはコンピューティング、ネットワーク、メモリに至るまでのスタック全体にわたる緊密な協調設計によって実現されており、これらすべてが一体となって最適化されています。
ここで 2 つの疑問が浮かびます。もし世代交代のたびにトークン生成のコストが劇的に下がるとしたら、コンピューティング リソースへの需要は縮小するのでしょうか。
答えは No、むしろ拡大します。
トークン単価が下がれば、経済的に採算の取れるユースケースが増加し、それらのユースケースが、効率化によって削減された分を上回る量のトークンを消費するからです。
2 つ目の疑問は、耐久性についてです。もし世代交代のたびに前世代よりもはるかに高性能になっていくならば、古い世代の製品はどうなるのでしょうか。
耐久性: 導入済みシステムが生み出す継続的な価値
すべてのワークロードに最新システムが必要なわけではありません。最適なシステムはワークロードの複雑さや形態によって異なるため、次世代製品が登場した後も、前世代の製品は引き続き収益を生み出し続けます。
2020 年に出荷された NVIDIA A100 GPU は、6 年経った今でも商用運用されており、その経済的価値が続いていることが実証されています。直近では CoreWeave が、2020 年に初めて導入した同 GPU ユニットの利用予約期間を 2029 年まで延長しました。長年にわたり、主要事業者各社は自社サーバーの減価償却期間を延長してきました。この期間設定は、ハードウェアが収益を生み出さなくなる時期を予測するものですが、その期間は常に長くなり続けています。Sprout が 2026 年 9 月に発表した分析レポート『The Productive Life of a Data Center GPU (データ センター用 GPU の稼働寿命)』では、主要事業者各社において、その期間設定がどのように推移してきたかを追跡しています。
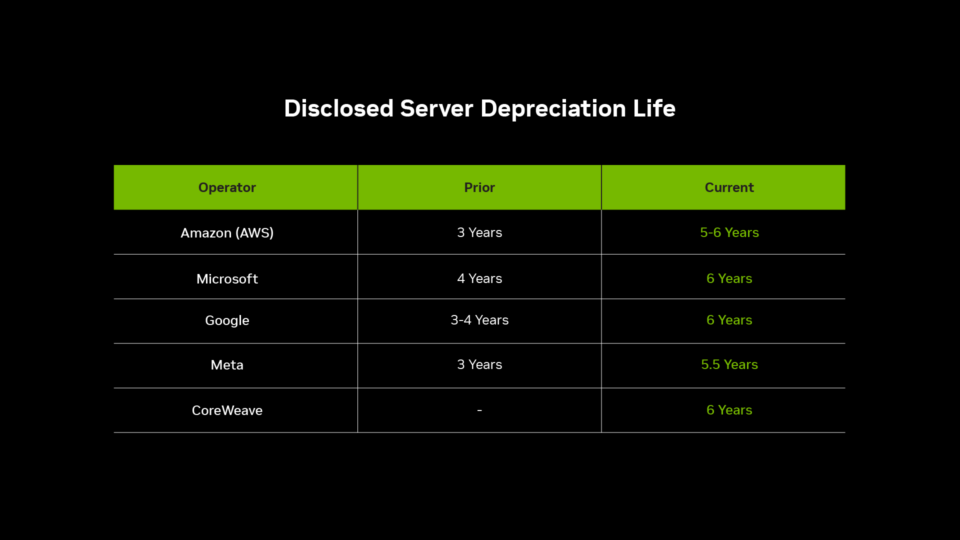
Barkr は、再販価格をベースに、8 基の H100 GPU を搭載したシステムの耐用年数を 5 年から 6 年、GB300 NVL72 を 9 年から 10 年と見積もっています。Silicon Data によると、購入から 6 年経過した A100 GPU でも依然として、購入価格の 4 分の 1 の価値を維持しています。5 年間の減価償却期間に基づけば、1 年以上前に帳簿価額はゼロになっているはずです。また、Ornn Data の調査によると、A100 GPU の 5 年間の長期契約でのレンタル料金でも、実際の市場では 1 か月契約の場合の 80% 相当で取引されています。
NVIDIA GPU のプログラミングに使用されるソフトウェア プラットフォームである CUDA は、世代を超えて利用できるため、新しいアーキテクチャが登場しても、事業者がすでに所有している機器が無用になることはありません。ソフトウェアとカーネルの継続的な最適化により、既存のハードウェアの性能は向上し続けています。
同じプラットフォーム上で、機械学習、ディープラーニング、生成 AI、リーズニング、エージェント型 AI、フィジカル AI まで実行できます。新たな種類の処理が登場しても、それらはすべて、すでに導入済みのハードウェア上で対応できました。
これこそが汎用性です。システムが対応できる処理の種類が多ければ多いほど、そのシステムはより長く、新たな役割を見出し続けることができるのです。
汎用性: あらゆる種類の AI、あらゆる段階、あらゆる場所に対応
ある特定の種類のワークロードに特化したファクトリーを構築することは、その作業が今後も続くことに対する賭けのようなものです。一方であらゆる作業に対応できるファクトリーは、作業内容が変化しても、その有用性を保ち、収益を生み出し続けます。
NVIDIA の AI ファクトリーでは、言語、視覚、生物学、物理学、ロボティクスといった多岐にわたる分野において、オープンソースから独自開発のものまで、あらゆる種類の AI モデルが稼働します。データ処理から事前トレーニング、ポストトレーニング、推論に至るまでのあらゆるフェーズに対応します。また、ハイパースケール環境や AI クラウドから、ソブリン AI プログラム、エンタープライズ データ センター、エッジに至るまで、あらゆる場所で稼働します。
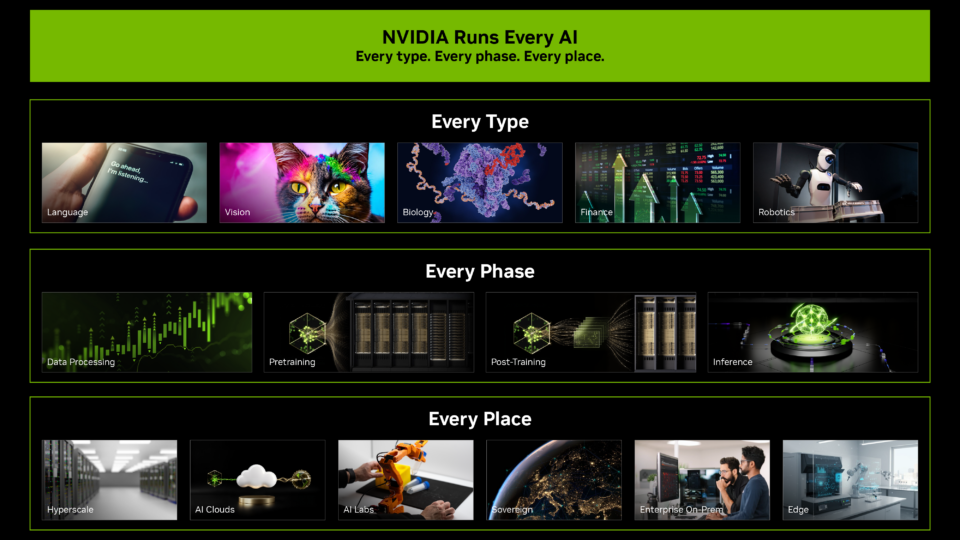
その用途は、AI モデルの構築や実行がすべてというわけではありません。同じインフラ上で、データ処理、科学技術計算、シミュレーション、グラフィックス処理なども実行します。
AI かどうかにかかわらず、これらすべてのワークロードは、最終的には同じ並列演算に帰着します。そして NVIDIA GPU は、まさにその演算を数千のコアで同時に実行できるよう設計されています。CUDA があるからこそ、光のシミュレーション、タンパク質の折り畳み構造、次のトークンの予測といった多様な処理がチップ 1 つで可能になるのです。その上には 1,000 以上のすぐに使える CUDA-X ライブラリが用意されており、ディープ ニューラルネットワーク、計算リソグラフィ、量子回路シミュレーションから、ベクトル検索、気候モデリングに至るまであらゆる用途を網羅し、1,000 万人以上の開発者がこれらを活用して開発を行っています。
これこそが、NVIDIA GPU を、単一のワークロード向けに構築されたカスタム ASIC とは一線を画す、汎用アクセラレーテッド コンピューティング プラットフォームを実現している理由です。汎用的であるということは、ありきたりであるという意味ではありません。Tensor コアや Transformer エンジンといった AI 最適化ハードウェアをプログラマブルなアーキテクチャに組み込むことで、専門性と柔軟性を単一のチップで両立させているのです。これらすべてを 1 つのアーキテクチャで実行するからこそ、高い稼働率を維持し、それに見合う投資対効果を実現しているのです。
この汎用性は、各顧客の実際の運用事例にも表れています。
- Lilly: 1,016 基の GPU を搭載したオンプレミスのクラスター上で、タンパク質、低分子化合物、ゲノミクスのモデルを構築、実行しているほか、自社チーム向けにチャットボットやエージェント型ワークフローも導入
- Pinterest: NVIDIA Blackwell、Hopper、およびそれ以前のアーキテクチャを含む 14,000 基の GPU を備えたハイパースケール クラウド上で、ビジョン言語モデルのポストトレーニングと展開を実施
- Revolut: NVIDIA cuDF を使用して数十億件の取引記録データを処理し、AI クラウド上で基盤モデルのトレーニングと展開を実施
- Runway: NVIDIA Hopper 上でワールド モデルのトレーニングを行い、クラウド インフラを活用して NVIDIA Blackwell プラットフォーム上でサービスを提供
- テキサス A&M 大学: スーパーコンピューター上で分子シミュレーションと AI による創薬を実行し、7 つの機関を横断する 26 のプロジェクトにおいて 95 – 98% という高い稼働率を達成
この汎用性は、さまざまなお客様の本番環境で発揮されています。同じような事例は AI の分野にとどまりません。Cosm は、NVIDIA を基盤とする分散型データ センターを運用しており、高解像度の動画再生、ストリーミング、リアルタイム グラフィックス、同期ディスプレイなど、幅広い用途で柔軟なコンピューティング リソースを提供しています。Dassault Systèmes は、ウィチタ州立大学の航空機認証や、Lucid Motors の車両設計における仮想ツイン シミュレーションを支援しています。また、Unilever は、写真撮影の代わりにデジタル ツインを用いて製品画像を作成することで、制作コストを半減させています。
ここで挙げた例はほんの一部にすぎません、それこそが重要な点なのです。
NVIDIA の AI ファクトリーは、生産性、耐久性、汎用性を重視して設計されています。つまり、収益性の高いトークン、より長い耐用年数、そして幅広い需要に対応することで、投資収益を最大化しているのです。
NVIDIA の AI ファクトリーについてさらに詳しく知りたい方は、10 月 21 日 (水) 午後 6 時 (日本時間) に開催される、NVIDIA の創業者/ CEO であるジェンスン フアン (Jensen Huang) による GTC Berlin での基調講演をご覧ください。