
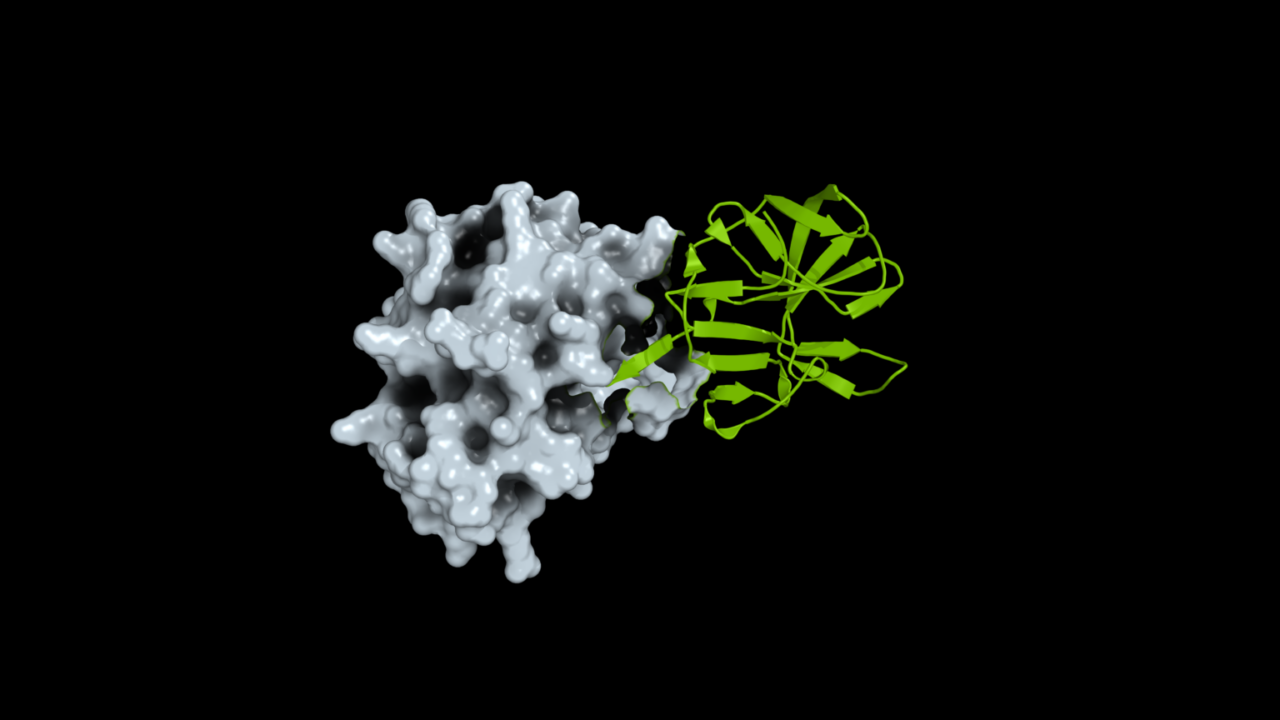
新型コロナウイルス (COVID-19) が出現した時、科学者たちには大きなアドバンテージがありました。コロナウイルスに関する研究を数十年にわたり蓄積していたため、ウイルスの重要なタンパク質について十分な理解を持っていたのです。おかげで、過去に例のない速さでワクチンを開発することができました。しかし、次にパンデミックが起こった時、同じように順調なスタートを切れるとは限りません。
より高確率で順調なスタートを切れるようにするため、NVIDIA は Google DeepMind や欧州分子生物学研究所 (EMBL) 付属の欧州バイオインフォマティクス研究所 (EMBL-EBI) といった世界的な研究機関の連合に参加し、2,800 種以上のウイルスのタンパク質複合体について予測された 3 次元構造データを公開しました。このデータは AlphaFold Database を通じて、世界中のあらゆる科学者が自由に利用できます。
このたび公開されたデータセットに収録されている構造データは、タンパク質がどのように折り畳まれて 3 次元構造を形成するかを予測する Google DeepMind の AI モデルである AlphaFold2 を用いて推論されており、この推論に NVIDIA BioNeMo Inference Runtime による最適化が加えられています。これにより、数千種類のウイルスのプロテオームという範囲まで推論の規模を拡大し、各ウイルスにコード化されているタンパク質複合体 (相互作用するタンパク質の集まり) を予測できるようになりました。
Google DeepMind のライフ サイエンス パートナーシップ マネージャーであるRisha Patel 氏は次のように述べています。「AlphaFold Database で私たちが常に目標としてきたのは、生物学研究の基盤となる知識へのアクセスを大規模に民主化することでした。数千ものウイルス タンパク質複合体をデータベースに追加する今回の協業により、世界中の科学者が、未来の感染症流行への備えに必要な知見を得られるようになるでしょう」
また NVIDIA は、このデータセットの生成に使用された GPU アクセラレーテッド ワークフローである BioNeMo Structure Prediction Pipeline もオープンに公開しています。これにより、研究者は、自身が研究対象とするタンパク質について、タンパク質配列から 3 次元構造を予測できるようになります。
次のパンデミックへの備えは、今すぐ始めなければなりません。 Center for Global Development の分析によると、2050 年までに世界が COVID-19 と同程度に深刻なパンデミックに直面する確率は約 50 % に上ると推定されています。
MRC-グラスゴー大学ウイルス研究センターの分子ウイルス学教授であり、本プロジェクトの共同研究者であるJoe Grove 氏はこう述べています。「次に起こるパンデミックは、まったく予想外のものから引き起こされるかもしれません。COVID-19 のケースでは蓄積されていたような知識が、次はないかもしれません。私たちが目指しているのは、そのような知識をある程度事前に蓄積しておくことです」
データベースに今回追加されるタンパク質相互作用のうち、約 30 % は科学的に完全に新規のものです。それらが示す相互作用構造は、実験によって決定されたタンパク質構造を集めた主要なデータベースであるタンパク質構造データバンク ( Protein Data Bank) にこれまで記録されたことがありません。今回得られた新たなデータは、生物学研究コミュニティによる探求や活用をへて、新しい発見につながる可能性があります。
NVIDIA のデジタル生物学部門で応用研究科学チーム リードを務めるクリス ダラゴ (Chris Dallago) は次のように述べています。「このデータベースは仮説を生み出すためのエンジンです。私たちは、タンパク質相互作用について調べている生物学研究者や AI コミュニティを支援しています。彼らがタンパク質を単一の分子としてだけでなく、複合体として研究できるようにすることで、この分野全体の前進を後押ししています」
複雑なタンパク質構造を予測する
ほとんどのタンパク質は単独で機能するのではなく、複数の分子が複合体を形成することで高度な機能を発揮します。ウイルスの働きを阻害するためにワクチンや薬剤が標的として注目すべきなのは、多くの場合、こうしたタンパク質複合体の構造です。
例えば、COVID-19 のスパイク タンパク質の 3 次元構造を解明できたことは、ワクチン開発の重要な基盤となりました。しかし、現在ほかの数千種類におよぶウイルスについて、そのような構造に関する知見は存在しません。今回公開されたデータセットは、こうした情報の空白を埋める第一歩となるものです。
タンパク質構造を決定するための従来の手法 (タンパク質の結晶化や X 線照射など) では、1 つの構造を解明するために、何年もの時間と数千ドルの費用がかかる場合もあります。一方、NVIDIA BioNeMo での最適化により NVIDIA GPU 上で効率的に動作するようになった AlphaFold2 は、数分で構造を予測でき、しかも大量の処理をまとめて実行することが可能です。科学者は、これらの信頼性の高い予測結果を、実験的手法を用いて検証することができます。
本プロジェクトにおいて、研究チームは一般的な風邪のウイルスから、Mpox のような新しい脅威に至るまで、ヒトに感染することが知られている様々なウイルス群のタンパク質構造を体系的に解析しました。
グローバルな協業と、世界に開かれたアクセス
このコラボレーションには、感染症流行対策イノベーション連合 (CEPI)、EMBL-EBI、Google DeepMind、NVIDIA、ソウル大学、成均館大学、スイス生物情報学研究所、グラスゴー大学が参加しています。
今回のデータセットの公開は、世界経済フォーラムがパンデミックの予防、備え、対応をテーマとしてニューヨークで開催された国連総会関連会合に合わせて行われました。この公開により AlphaFold Database はさらに拡充されています。現在は 2 億 6,000 万件を超えるタンパク質およびタンパク質複合体の構造予測データが収録されており、科学的に知られカタログ化されているタンパク質のほぼすべてを網羅しています。
「このデータをオープンに公開することは、ウイルス診断についての理解を深め、治療法やワクチンを開発する上で極めて重要です」と、EMBL-EBI の暫定所長であるJo McEntyre 氏は言います。「このデータセットは、これまであまり研究されてこなかったウイルスもカバーしています。また、感染症流行に最前線で対応しているものの研究資源が限られているという科学者にとっても、研究のハードルを下げることにつながります」
今回のオープン データセットに収録された予測には、信頼度の指標が示されています。これらの構造データからは、ウイルス複合体がどのような構造をとっている可能性があるか、またウイルスのプロテオーム内で個々のタンパク質がどのように相互作用している可能性があるのかが分かります。
全体として、この新しいデータは、デジタル生物学や疾病研究に携わる科学者たちが利用できる情報に多大な貢献をもたらすものです。
Grove 氏はこう語ります。「私が博士課程にいた頃は、研究対象のタンパク質について、利用可能な構造データが一つもなく、まるで暗闇の中を手探りで研究しているようなものでした。何が起きているのか、推測するしかなかったのです。今回公開されたデータセットは、いま博士課程で研究に取り組んでいるすべての方にとって強力なツールとなります。高品質な構造データを利用できるようにすることで、基礎科学の進展を加速させてくれるでしょう」
AlphaFold Database Pandemic Preparedness Portal でウイルス タンパク質複合体のデータセットを見て回り、BioNeMo Structure Prediction Pipeline で対象タンパク質の構造を予測しましょう。また、NVIDIA BioNeMo の詳細もご確認ください。