
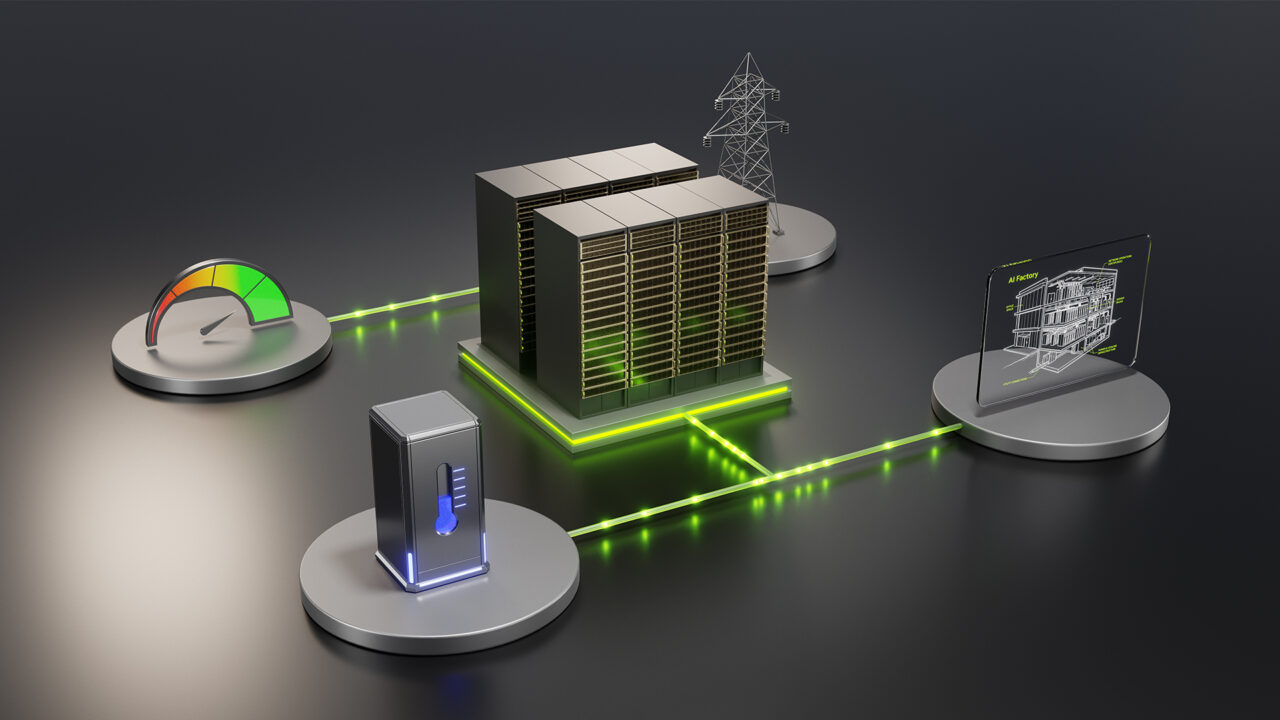
シリコン バレーのうだるような暑さの 8 月の夕方、日が沈み、空調負荷が急増する中、Silicon Valley Power (カリフォルニア州サンタクララ市が所有・運営する公営電力会社) は、ある AI ファクトリーに対し、電力消費量の調整を要求する信号を送信しました。
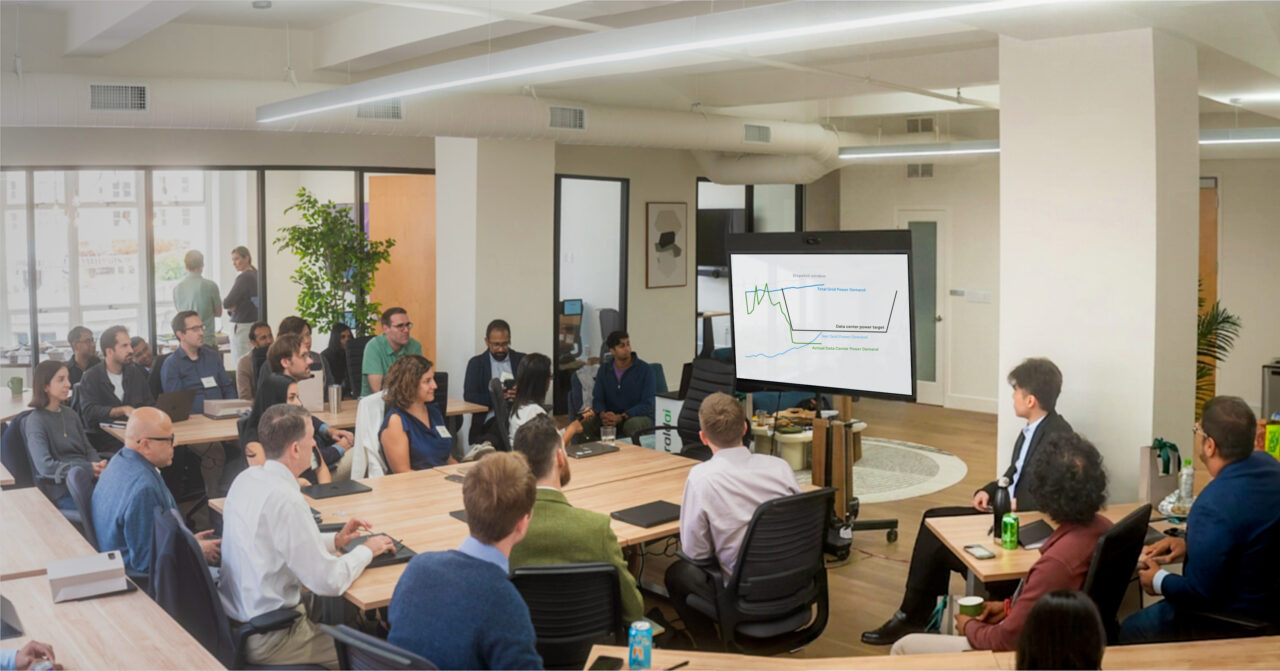
Varun Sivaram 氏は、サンフランシスコの自社会議室で、Emerald AI のチーム メンバー、データセンターのエンジニア、電力会社関係者など、約 40 人と共に、その様子を Zoom で見ていました。誰も何も操作をしていません。
NVIDIA のパートナー企業である Emerald AI のグリッド オーケストレーション プラットフォームであり、NVIDIA DSX Flex が実現を目指す柔軟性の初期事例もある Conductor は、グリッドの状態に関する信号を受信して、データセンターの柔軟なコンピューティング ワークロードを調整します。待機可能な作業は速度を落とすか、スケジュールを変更するのに対し、優先度の高いサービスは稼働を継続します。
目標は、グリッドが逼迫したときに、重要な AI ワークロードを中断することなく電力需要を削減することで、これはまさに Silicon Valley Power が必要としていたことです。
電力需要の削減が画面に表示されると、誰もが歓声を上げました。
「私たちは息をのんで見守っていました。数千基の NVIDIA GPU に展開するのは今回が初めてでした」と Sivaram 氏は述べ、同社製品責任者の Mansi Shah 氏は、感極まった様子で「まるで SpaceX のロケット打ち上げのようです」と語ります。
Silicon Valley Power は、その後もその AI ファクトリーに 200 回以上の需要信号を送信し、毎回うまくいきました。
これは本番環境におけるグリッドの柔軟性を示すものです。また、サンタクララの一施設をはるかに超える大きな何かを示唆しています。それは、新たな送電線の建設を 10 年も待つことなく、アメリカの AI ファクトリーが必要とする電力を確保する道筋です。
AI Infra Summit にて、NVIDIA のハイパースケールおよびハイパフォーマンス コンピューティング担当バイス プレジデントであるイアン バック (Ian Buck) は、インフラに関する基調講演の中心テーマとして、AI ファクトリーの効率化を取り上げました。
クラウド プロバイダーの Lambda が同日発表した展開環境における初の検証結果は、それを数値で示しており、固定電力予算でも適切に管理すれば、トークン スループットを 24% 向上させることが可能だということです。
Lambda のクラウド サービス担当プレジデントである Dave Ward 氏は次のように述べています。「今回の PoC により、固定電力予算の制約を克服できたと確信しています。NVIDIA DSX MaxLPSは、余剰容量を回収して実際の利用に変換する道を開くと同時に、同じフットプリントで計算密度の大幅な向上を実現します」
その 8 月の夕方、SVP が要求すると、Conductor は事前定義されたワークロード階層に従って処理を実行しました。優先度の高い推論処理は継続したまま、優先度が最も低いジョブの処理速度を落とすと、消費電力は 4 メガワットから 3 メガワットへと低下しました。すべて自動化され、オペレーターは不要でした。
AI ファクトリーの経済において、電力は制約要因です。指標はギガワットあたりの処理量です。データ センター事業者は効率性を非常に重視しており、1 ワットたりとも無駄にすることなく、生産的なコンピューティングに活用することを目差しています。そうすることで、業界は施設設計からラックレベルの電力変換に至るまで、スタックのあらゆる層において目覚ましい進歩を遂げてきました。
DSX は、その規律を AI ワークロード自体にも適用します。よりスマートなラック プロビジョニングにより、ワークロードが実際に必要とする場所に電力を供給します。スケジューリングの厳密化、再起動の高速化、チェックポイント処理の効率化などの運営上のインテリジェンスにより、GPU は待機なく常時稼働し続けます。その目標は、オペレーターが常に追求してきたことと同じで、与えられた電力からより多くの処理を実行することです。
NVIDIA の創業者/CEO であるジェンスン フアン (Jensen Huang) は、「1 ギガワットのファクトリーが 2 ギガワットのファクトリーになることはあり得ません」と述べています。
システムが物理的な限界に達したときにエンジニアがたどり着く答えは常に同じです。それは、部品の個別最適化をやめて全体設計を始めることです。
5 月に GTC Taipei で発表された NVIDIA DSX は、AI ファクトリーにとってのその答えであり、その有効性は初期導入事例ですでに実証されています。
この包括的なプラットフォームは、ネットワーク、冷却、節水、設備設計などを網羅しています。以下で、電力管理とグリッドへの参加に関するこれまでの主な成果に注目します。
同じ予算でより多くの処理を実現: DSX MaxLPS
AI Infra Summit で発表された Lambda の成果は、NVIDIA HGX B200 GPU サーバー上での DSX MaxLPS の初の検証結果です。
DSX MaxLPS は、GPU およびラックレベルの消費電力を監視し、ワークロードの種類に基づいて余剰電力をノード間で再配分することで、静的プロビジョニングでは無駄になる容量を回収します。トレーニングと推論では消費電力が異なるため、MaxLPS は両方を実行する AI ファクトリーにおける配分を最適化します。
AI ネイティブのスタートアップ企業からハイパースケーラーまで、1 万社以上の顧客にサービスを提供する GPU クラウド プロバイダーである Lambda は、5 ラック、19 ノードのクラスター上でこのソフトウェアを実行しました。
その結果、16 ノードのフルパワー稼働時と同じ電力予算内で 19 ノードを稼働させることで、クラスター全体のトークン スループットが、毎秒約 400 万トークンから 500 万トークンへと 24% 向上しました。また、ワットあたりのパフォーマンスも 23% 向上しました。
NVIDIA の予測では、DSX MaxLPS は適切な展開環境において、次世代の Vera Rubin NVL72 AI ファクトリーに対し、同じメガワット電力予算で最大 40% の GPU 容量拡大を実現できます。
本番環境で実証された自動需要応答
サンタクララの事例は、単なる DSX Flex の導入事例にとどまらず、このコンセプトが商用規模で機能することを証明したことです。
NVIDIA の Eos AI ファクトリーは、AI ファクトリーをディスパッチ可能なリソースとして扱うことを目的とする初の商用グリッド ユーティリティ プログラムである、Silicon Valley Power の Flexible Load Interconnect Program に参加し、Emerald AI Conductor を稼働させています。
Silicon Valley Power が信号を送信すると、Conductor は 1 分以内に応答します。柔軟に対応できる AI ファクトリーは、より大規模な操業が可能になります。
それこそが、DSX Flex が普及を目指すパターンであり、プラットフォームの成熟に伴い、Emerald AI Conductor は DSX Flex に統合されることになります。DSX Flex の初の商用展開先は、バージニア州マナサスの NVIDIA AI Factory Research Center 内の、2 大陸で実施された 5 回の先行実証実験に基づく 96 メガワット Vera Rubin AI ファクトリーとなる予定です。
次世代の電源アーキテクチャ層: 800V DC 電源アーキテクチャ
今日の AI ファクトリーにおける成果は現実のものであり、直ちに導入可能です。次の層は、より高密度なアクセラレーテッド コンピューティング ラックに電力を供給する方法です。
AI ファクトリーの規模拡大に伴い、従来の低電圧電力経路では変換の複雑さや配電上の制約が増大します。
NVIDIA の 800V DC アーキテクチャは、変換の複雑さを軽減し、電力供給効率を向上させることで、より高密度なアクセラレーテッド コンピューティング ラックをサポートできるように設計されています。
NVIDIA DSX は、リファレンス デザインに 800V DC を組み込んでいます。
部品ではなくファクトリー全体を最適化
それだけで AI ファクトリーを最適化できる構成要素というものはありません。GPU を高速化してもネットワークを待つことに変わりはなく、不適切なプロビジョニングにより電力が無駄になる可能性があります。また、冷却のオーバーヘッドも GPU から電力を奪います。直接液冷式の GB200 NVL72 ラックの場合、約 120 kW の熱が発生し、その電力が演算処理に達する前にどこかに放出する必要があります。
メガワットあたりのトークンを増やすための唯一確実な方法は、最初のラックを設置する前に DSX Sim、稼働開始後に DSX OS と DSX Exchange、さらにはビルダーがゼロからではなく検証済みのアーキテクチャから始められるように DSX リファレンス デザインを活用して、ファクトリー全体を最適化することです。 DSX スイート全体の概要については以下の概要をご参照ください。
ギガワット インフラの標準
結局のところ、そのファクトリーが消費電力 1 メガワットあたり、どれだけの有用な処理を生み出すかという問題に集約されます。
NVIDIA DSX は、現行のハードウェアから次世代のハードウェアに至るまで、その指標において競争力を維持するために必要なリファレンス デザイン、シミュレーション ツール、運用ソフトウェア、電力管理技術をインフラ ビルダーに提供します。
グリッドの負荷軽減が必要になったとき、ファクトリーは処理を中断することなく、電力供給の追加を要求することもなく、それに応じました。
NVIDIA DSX は、それを AI ファクトリーが果たすべき役割の新たな基準として確立します。